
Suy luận LLM là quá trình dự đoán từng phần tiếp theo
Suy luận LLM là quá trình mô hình xử lý các token trong ngữ cảnh rồi dự đoán những token tiếp theo để tạo câu trả lời, chứ không phải suy nghĩ như con người. Khi mô hình sinh phản hồi, nó dựa vào nội dung đầu vào và phần văn bản đã tạo để tiếp tục dự đoán; vì vậy, ngữ cảnh dài có thể giúp câu trả lời bám sát cuộc trò chuyện hơn nhưng cũng làm tăng nhu cầu bộ nhớ. Nắm được nguyên tắc này giúp người triển khai hiểu vì sao tốc độ không chỉ phụ thuộc vào số tham số hay sức mạnh GPU. Trọng số mô hình chiếm một phần bộ nhớ, còn KV cache tăng theo nội dung cần giữ trong quá trình sinh. Chọn mô hình và cấu hình phù hợp vì thế là bài toán cân bằng giữa khả năng xử lý, độ dài ngữ cảnh và tài nguyên sẵn có.
Trọng số mô hình quyết định phần nền bộ nhớ
Trọng số mô hình là các giá trị biểu thị mức độ liên hệ giữa những thành phần trong các lớp tính toán của mô hình; chúng định hình cách mô hình liên kết token khi tạo đầu ra. Các nhãn như 4B, 8B hay 20B cho biết số tham số, thường được tính bằng hàng tỷ ở các mô hình dành cho người dùng phổ thông. Số tham số càng lớn thường đòi hỏi nhiều bộ nhớ hơn, nhưng không tự động đồng nghĩa với câu trả lời tốt hơn. Dung lượng còn phụ thuộc vào độ chính xác dữ liệu dùng để biểu diễn trọng số: giá trị càng chính xác thường cần nhiều chỗ lưu hơn. Đây là lý do các GPU có VRAM hạn chế thường không thể chạy mọi mô hình nguyên trạng. Người triển khai nên xem số tham số là chỉ dấu ban đầu, rồi đánh giá thêm định dạng trọng số, độ dài ngữ cảnh và khả năng phần cứng.
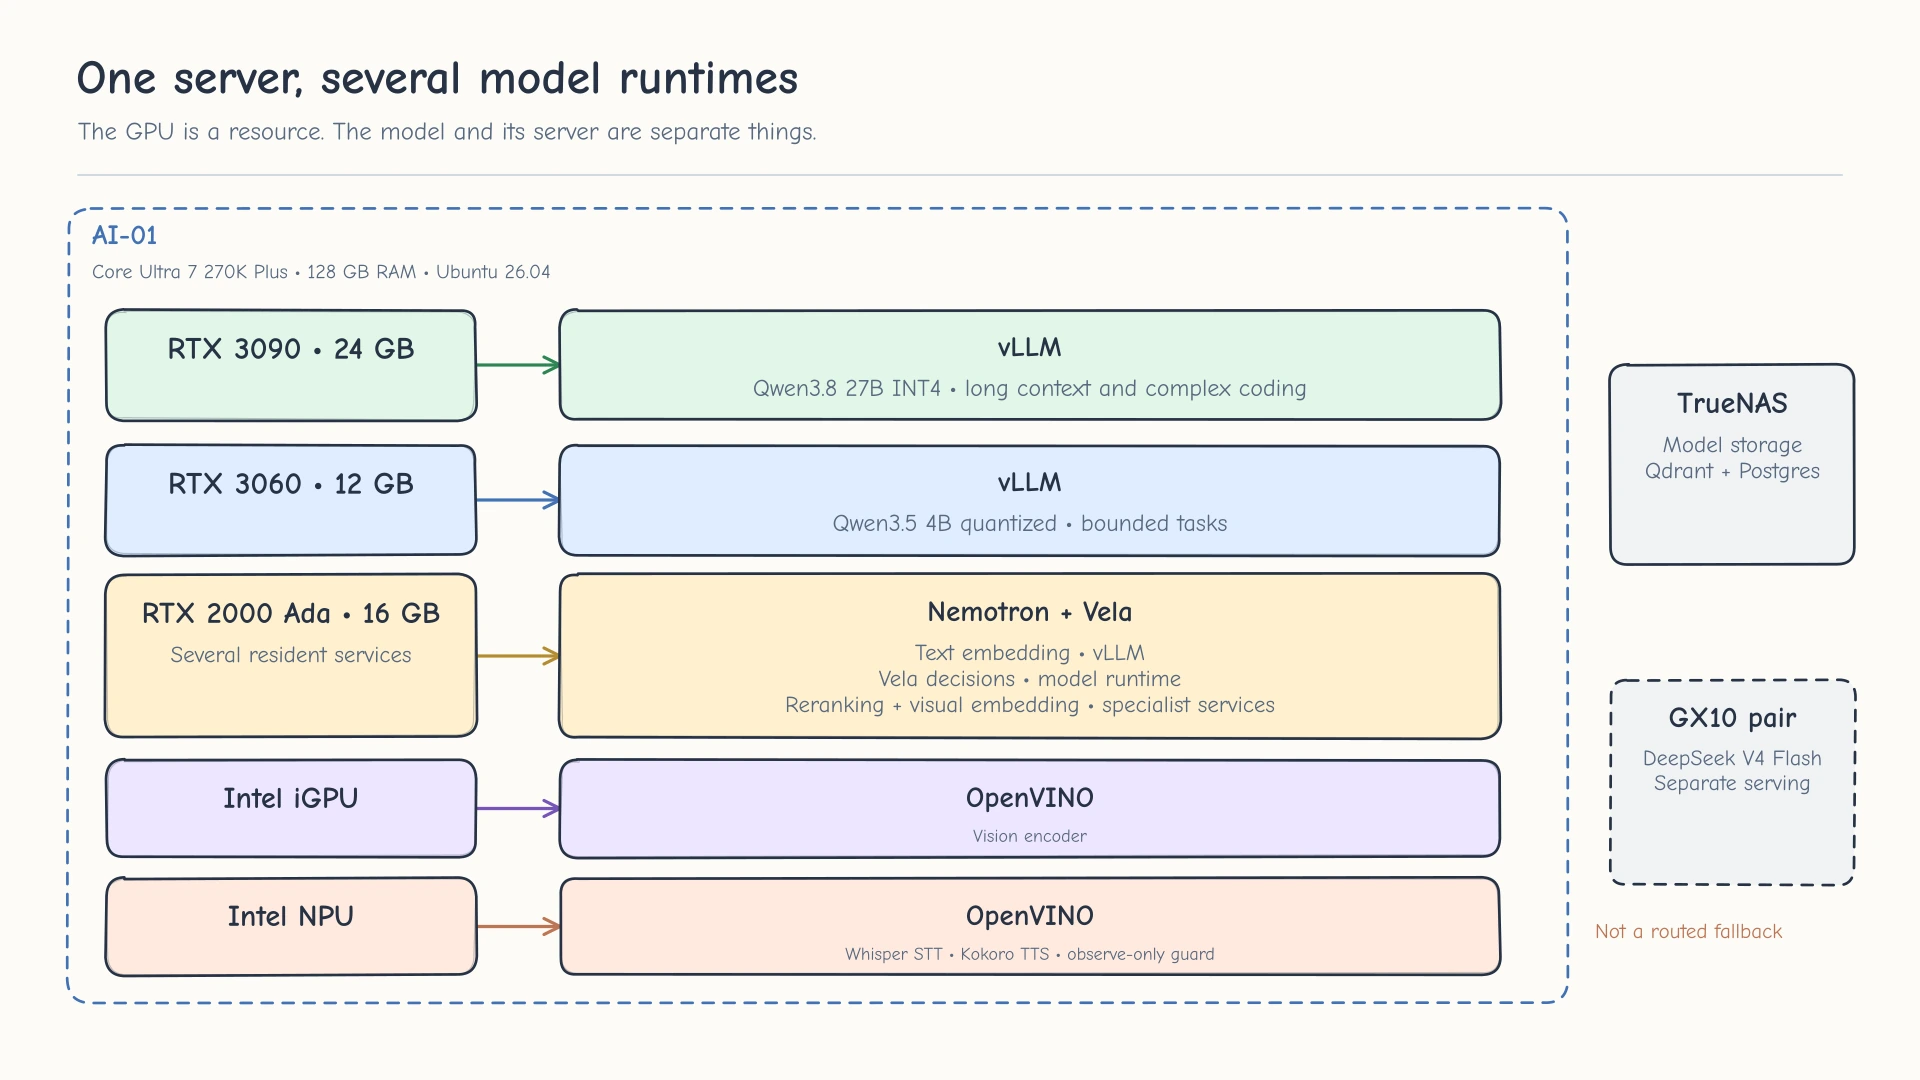
Khi chạy suy luận, trọng số phải được lưu để mô hình thực hiện tính toán. Bởi vậy, lựa chọn một mô hình lớn hơn không chỉ ảnh hưởng đến năng lực xử lý mà còn thu hẹp phần bộ nhớ còn lại cho KV cache và các tác vụ khác. Trong một nền tảng tự triển khai, phân công mô hình theo việc cần làm có thể hợp lý hơn việc dùng một mô hình lớn cho mọi yêu cầu: tác vụ ngắn, đơn giản có thể chạy trên mô hình nhỏ, còn yêu cầu dài hoặc cần suy luận phức tạp dành cho mô hình lớn. Cách bố trí này giúp người vận hành cân đối tài nguyên theo nhu cầu thay vì chỉ chạy theo con số tham số.
KV cache giúp sinh tiếp mà không tính lại từ đầu
Trong lúc xử lý chuỗi token, mô hình tạo ra các giá trị khóa và giá trị, thường gọi chung là KV; KV cache lưu lại những thông tin tính toán này để có thể dùng lại trong cùng phiên. Nhờ đó, khi người dùng gửi câu tiếp theo hoặc mô hình sinh thêm token, hệ thống không phải tính lại toàn bộ phần ngữ cảnh đã xử lý. Đây là yếu tố quan trọng với hội thoại nhiều lượt: nếu không có bộ nhớ đệm, việc xử lý lại một cuộc trò chuyện dài sẽ khiến quá trình chậm hơn khi số token tăng lên. Vì thế, KV cache không phải phần có thể bỏ qua khi ước tính tài nguyên. Với ngữ cảnh lớn và hội thoại dài, nó có thể chiếm nhiều bộ nhớ hơn cả mô hình cùng trọng số.
Đổi lại, KV cache tiêu thụ VRAM để giữ dữ liệu dùng lại. Ngữ cảnh dài có thể hỗ trợ mô hình tiếp nhận thêm thông tin, nhưng yêu cầu bộ nhớ cũng tăng theo; vì vậy, bật cửa sổ ngữ cảnh lớn nhất không phải lúc nào cũng là lựa chọn tốt. Một số mô hình giảm độ chính xác biểu diễn của nội dung trong KV cache để tiết kiệm VRAM, chấp nhận khả năng suy giảm độ chính xác nhỏ. Khi triển khai, nên kiểm tra độ dài hội thoại thực tế, lượng bộ nhớ dành cho trọng số và mức chất lượng chấp nhận được. Nếu chỉ nhìn vào dung lượng tệp mô hình, người vận hành có thể đánh giá thiếu bộ nhớ cần thiết khi phục vụ các phiên dài.
Lượng tử hóa mô hình là phép đánh đổi, không phải phép màu
Lượng tử hóa mô hình giảm yêu cầu bộ nhớ bằng cách chuyển các trọng số có độ chính xác cao sang dạng biểu diễn gọn hơn, gần như làm tròn có chủ đích. Dữ liệu nhẹ hơn giúp mô hình dễ vừa VRAM và có thể chạy trên phần cứng phổ thông; độ chính xác càng thấp thì khả năng chạy trên thiết bị hạn chế càng cao. Tuy nhiên, lượng tử hóa không tạo thêm năng lực cho GPU và cũng không đảm bảo đầu ra giữ nguyên chất lượng. Mức đánh đổi phù hợp tùy vào tác vụ: một định dạng có thể đáp ứng tốt câu hỏi ngắn nhưng không nhất thiết là lựa chọn tốt nhất cho công việc đòi hỏi độ chính xác cao. Vì vậy, đừng chọn định dạng chỉ vì nó nhỏ nhất; hãy thử với yêu cầu thật và quan sát cả chất lượng lẫn tốc độ.
Ba khái niệm này giải thích vì sao hiệu năng suy luận LLM là kết quả của nhiều yếu tố cùng lúc. Trọng số đặt ra mức bộ nhớ nền, KV cache giữ thông tin để sinh tiếp nhanh hơn nhưng tăng theo ngữ cảnh, còn lượng tử hóa giúp giảm mức chiếm dụng bằng cách hạ độ chính xác biểu diễn. Người triển khai nên đo cả thời gian phản hồi và mức sử dụng VRAM trên các phiên làm việc điển hình, thay vì chỉ dựa vào thông số mô hình. Kết luận rất thực tế: chọn mô hình vừa đủ, đặt giới hạn ngữ cảnh theo nhu cầu và lượng tử hóa có kiểm chứng thường hữu ích hơn việc cố chạy mô hình lớn nhất bằng mọi giá.