
textGrain: dấu ấn vô hình mở màn cuộc chiến phát hiện nội dung AI
Watermark AI vô hình trong văn bản là kỹ thuật nhúng một mẫu nhận diện bí mật vào cách mô hình chọn và sắp xếp từ, sao cho người đọc không thể nhìn thấy bằng mắt thường nhưng các công cụ chuyên dụng có thể phát hiện, nhằm truy vết nội dung do AI tạo ra và hỗ trợ minh bạch về nguồn gốc văn bản trong bối cảnh bản quyền và AI ngày càng căng thẳng. Trong vài tuần tới, người dùng ChatGPT và Codex đủ điều kiện tại Liên minh châu Âu sẽ bắt đầu nhận được văn bản có gắn watermark ẩn mang tên textGrain. OpenAI nhúng dấu này vào quy luật thống kê khi mô hình chọn từ, không để lại bất kỳ biểu ngữ hay ký hiệu nào có thể nhìn thấy. Động thái này không phải trò kỹ thuật thuần túy, mà là câu trả lời trực diện cho yêu cầu minh bạch của Đạo luật Trí tuệ nhân tạo của EU, đồng thời mở ra một mặt trận mới: cuộc chiến phát hiện nội dung AI trong đời sống số.
textGrain OpenAI: công cụ mạnh nhưng không phải "máy nói thật"
Về mặt kỹ thuật, textGrain là bước tiến đáng kể trong phát hiện nội dung AI, nhưng nó xa mới đạt tới mức "máy nói thật" mà giáo viên hay nhà xuất bản đang kỳ vọng. Theo thử nghiệm, ở mức nhận diện sai 1%, công cụ phát hiện được khoảng 80% đoạn văn 200 token và 95% đoạn 400 token. Đây là con số ấn tượng và cho thấy watermark AI vô hình có thể hoạt động hiệu quả trong điều kiện lý tưởng. Vấn đề nằm ở chỗ: văn bản hiếm khi giữ nguyên. Chỉ cần thay 10% từ bằng từ đồng nghĩa, tỷ lệ phát hiện với đoạn 400 token giảm còn 66%; nếu thay 25% thì tụt xuống khoảng 17%. OpenAI thừa nhận textGrain không đảm bảo phát hiện tuyệt đối, không thể xác minh độ chính xác nội dung, cũng không xác định được ai là người tạo ra văn bản hay mức độ chỉnh sửa của con người. Vì vậy, với giáo viên, nhà tuyển dụng và nhà xuất bản, kết quả phát hiện chỉ nên được xem là dữ liệu tham khảo, không phải bản án về quyền tác giả hay gian lận.
Ngành xuất bản: phản đối AI ngoài mặt, âm thầm dùng AI nội bộ
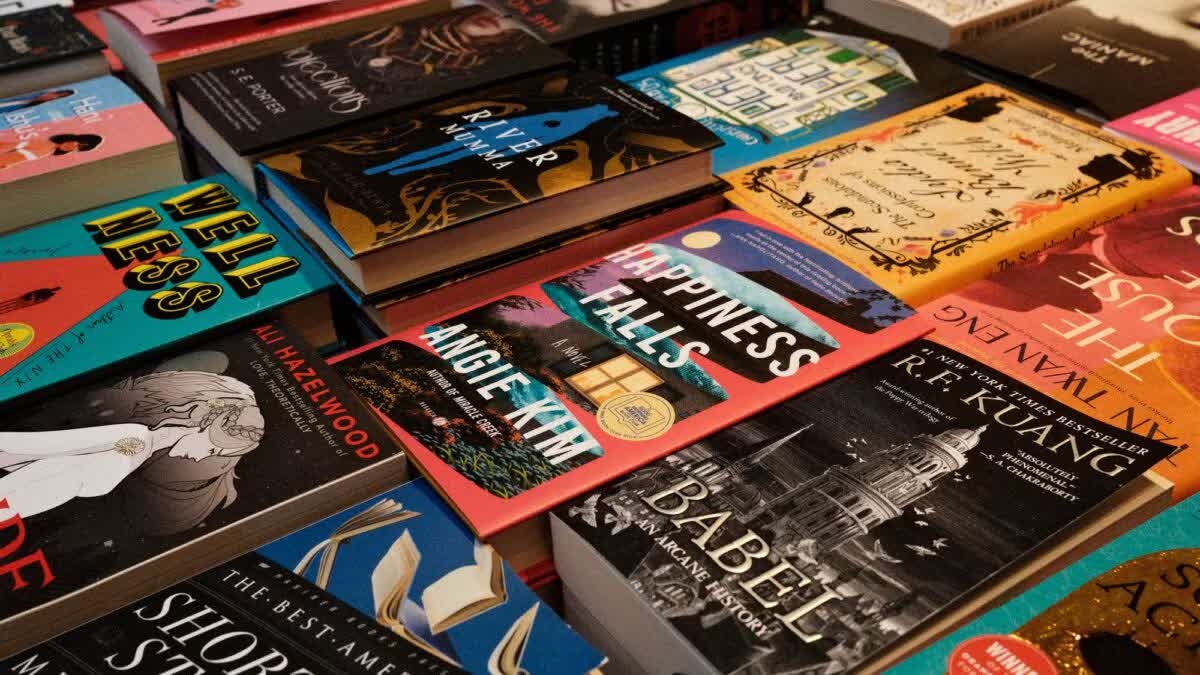
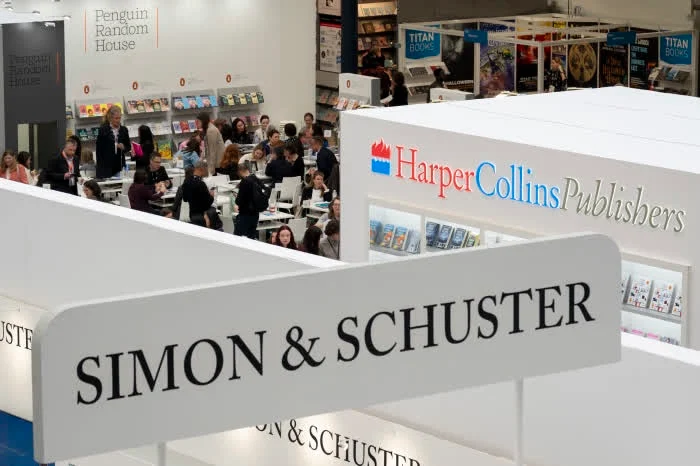
Trong khi OpenAI cố gắng gắn nhãn cho nội dung AI, nhiều nhà xuất bản lớn lại đang cố gắng xóa dấu vết sử dụng AI của chính mình. Ít nhất ba trong số năm nhà xuất bản lớn nhất tại Mỹ – HarperCollins, Simon & Schuster và Hachette – đã âm thầm đưa các công cụ AI vào quy trình xuất bản mà không công khai hoặc xin phép tác giả. Theo lời hơn 20 nhân viên, họ dùng Claude, ChatGPT và các công cụ khác để gửi email, soạn nội dung quảng bá sách, thiết kế bìa, tạo tài liệu tiếp thị, thậm chí tổ chức cuộc thi nội bộ tìm cách ứng dụng AI hiệu quả nhất. Thông điệp chính thức lại mang màu sắc khác. Người phát ngôn của Hachette nói công ty chỉ ủng hộ AI cho mục đích vận hành, nhưng không ủng hộ dùng AI trong hoạt động sáng tạo hay trao đổi với tác giả. Đại diện Simon & Schuster khẳng định nhân viên có quyền truy cập một số công cụ AI ở cấp độ doanh nghiệp, song việc sử dụng là không bắt buộc và bị giới hạn ở các công cụ "đã kiểm duyệt". HarperCollins thì chọn im lặng trước yêu cầu bình luận. Sự lệch pha giữa lời nói và việc làm này khiến niềm tin của tác giả và độc giả bị bào mòn.
Áp lực năng suất, bản quyền và sự thiếu minh bạch
Nếu chỉ nhìn bề mặt, có thể nghĩ các nhà xuất bản đang đạo đức giả. Nhưng câu chuyện phức tạp hơn: phía sau là áp lực năng suất và chi phí khiến AI trở thành "lối tắt" hấp dẫn. Một số nhân viên tại năm nhà xuất bản lớn cho biết họ miễn cưỡng thử nghiệm AI vì các CEO đã cắt giảm nhân sự mạnh tay, rồi tăng gấp ba khối lượng công việc của họ. Trong bối cảnh đó, việc dùng AI để viết nội dung quảng bá, thư từ chối, mô tả bìa sau, hay tạo hình ảnh bìa trở nên phổ biến. Nhưng lối tắt này va thẳng vào vùng nhạy cảm: bản quyền và AI. Các biên tập viên cho biết những cuốn sách bị hủy xuất bản do tác giả âm thầm dùng AI chỉ là "phần nổi của tảng băng chìm". Đại diện văn học lo ngại bản thảo của tác giả bị đưa vào phần mềm AI để sinh ra thư từ chối hay nội dung quảng cáo mà không có sự đồng ý. Trong khi đó, textGrain và các watermark khác vẫn hoạt động độc lập, chưa thể kiểm tra chéo, nên thị trường chưa có công cụ chung để phát hiện văn bản AI một cách nhất quán.
Cuộc chiến watermark AI vô hình: minh bạch không thể là lựa chọn tùy tiện
Điều đáng lo không phải là việc ngành xuất bản dùng AI, mà là cách họ dùng: âm thầm, thiếu quy định rõ ràng, trong khi công khai tỏ ra cảnh giác với AI. Nhiều người trong ngành mong muốn các nhà xuất bản đưa ra hướng dẫn và quy định công khai về việc sử dụng AI, làm rõ công nghệ nào đang được dùng và vào thời điểm nào. Một nhân viên tại HarperCollins nhận xét công ty chưa đưa ra bất kỳ chỉ đạo nào vì "nếu khơi ra thì sẽ tạo nên một làn sóng phản đối dữ dội". Ở phía ngược lại, textGrain OpenAI và các watermark AI vô hình khác đang cố xây dựng hạ tầng truy xuất nguồn gốc nội dung số. Nhưng khi kết quả phát hiện chỉ giống lời khai của một nhân chứng, không phải bằng chứng quyết định, thì minh bạch vẫn phụ thuộc vào thái độ của tổ chức hơn là công nghệ. Nếu các nhà xuất bản tiếp tục xuất bản dùng AI nội bộ nhưng né tránh đối thoại, cuộc chiến phát hiện nội dung AI sẽ không chỉ là câu chuyện kỹ thuật, mà là cuộc khủng hoảng niềm tin. Lối ra duy nhất là thừa nhận AI hiện diện ở mọi khâu, gắn nhãn trung thực cho nội dung, và đặt lại câu hỏi: chúng ta bảo vệ bản quyền và tác giả bằng luật chơi mới, chứ không bằng sự im lặng.