
Mở khóa phần năng lực AI bị giới hạn
Mở khóa GPU NVIDIA trong câu chuyện này là dùng công cụ phần mềm không chính thức để gỡ giới hạn tốc độ phát lệnh cho một số phép tính ma trận FP16 và BF16 trên GeForce, chứ không phải thêm nhân xử lý hay thay đổi phần cứng. Các nhà phát triển cộng đồng vừa công bố những cách can thiệp áp dụng cho một số GPU RTX 20, 30 và 40 series.
Lý do tồn tại khoảng trống hiệu năng là một số card chơi game GeForce dùng nền tảng silicon tương tự GPU workstation nhưng bị giới hạn thông lượng tính toán bằng firmware. Với các phép tính FP16 hoặc BF16 có tích lũy FP32, một số mẫu chạy ở tốc độ thấp hơn chế độ tích lũy FP16. Những công cụ mới nhắm vào giới hạn đó; chúng không ép xung và cũng không tăng băng thông bộ nhớ.
Đây là bước đáng chú ý với người chạy AI cục bộ, nhưng gọi nó là nâng cấp miễn phí sẽ gây hiểu lầm. Các dự án khác nhau hỗ trợ những thế hệ và mẫu card khác nhau, còn quá trình can thiệp diễn ra ở giai đoạn khởi động. Hiệu năng AI GeForce vì thế có thể được cải thiện trong những phép toán phù hợp, nhưng chưa biến mọi card thành GPU workstation.
Benchmark Tensor tăng gần gấp đôi, ứng dụng thì không
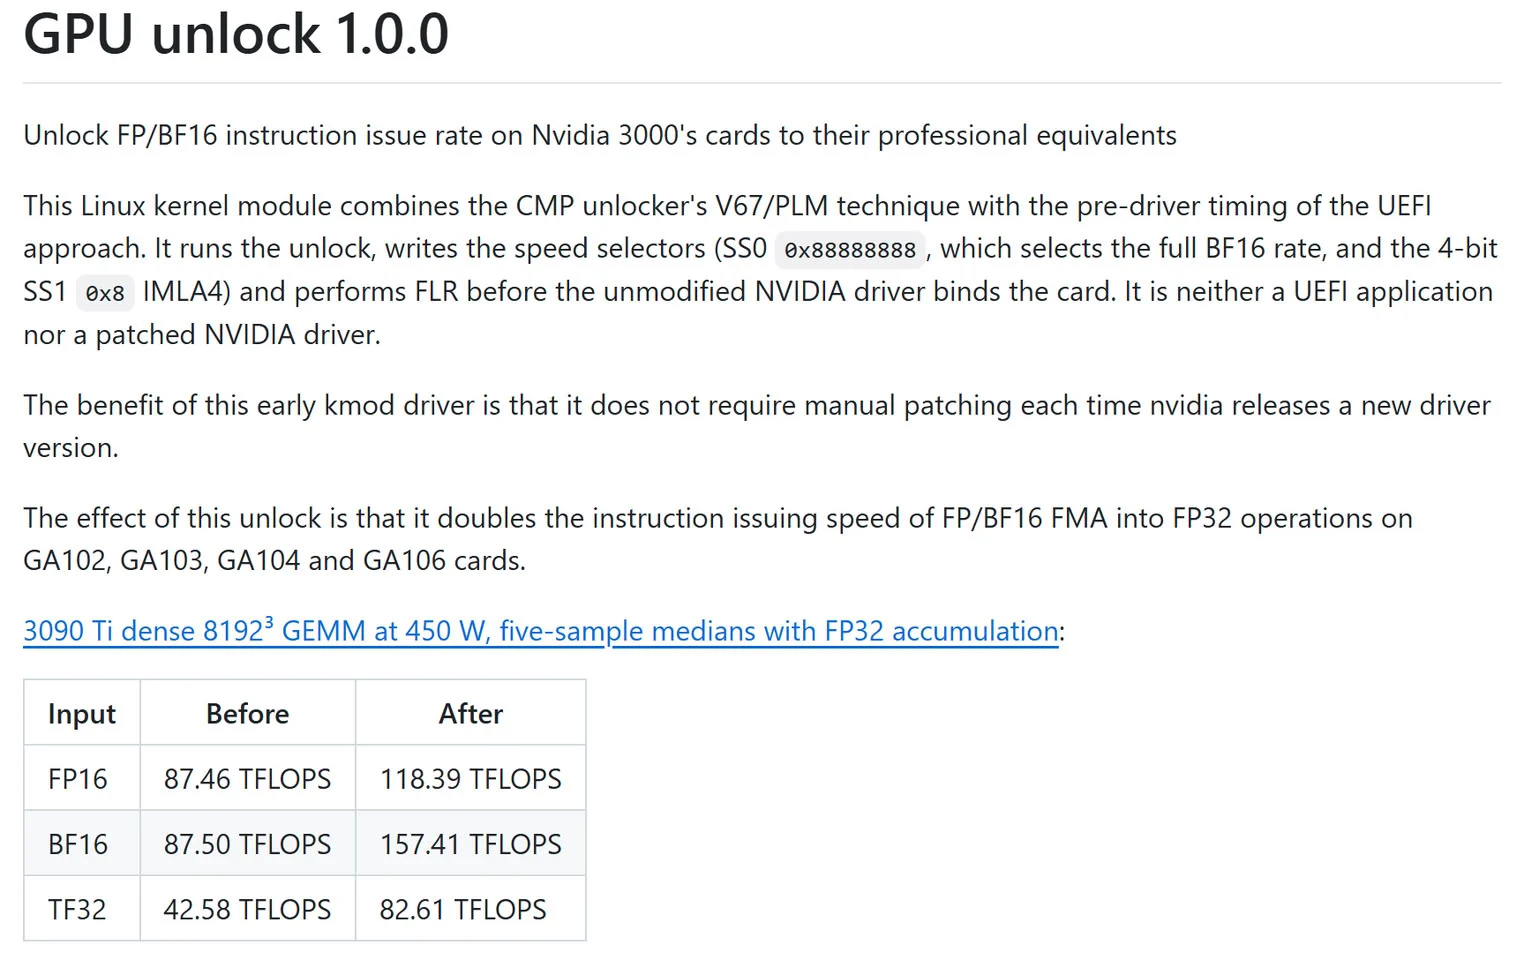
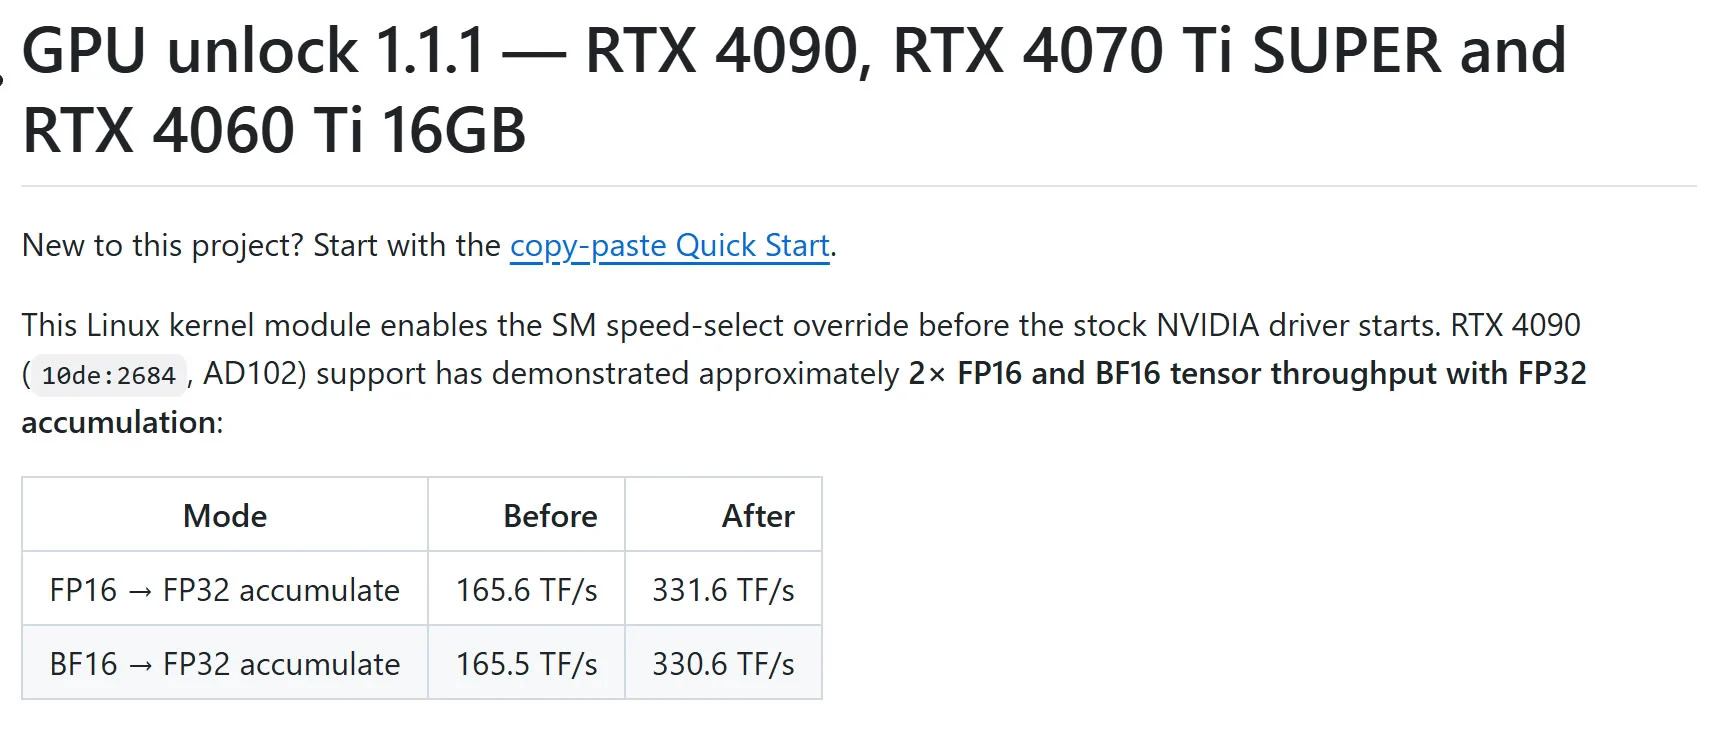
Các con số đỉnh rất bắt mắt: benchmark Tensor RTX ghi nhận RTX 4090 tăng thông lượng FP16 từ 165,6 lên 331,6 TFLOPS; RTX 3090 Ti đạt 157,4 TFLOPS BF16, so với 87,5 trước khi mở khóa. Một số thử nghiệm RTX 3090 Ti còn báo cáo mức tăng khoảng 35% với FP16, 80% với BF16 và 94% với TF32.
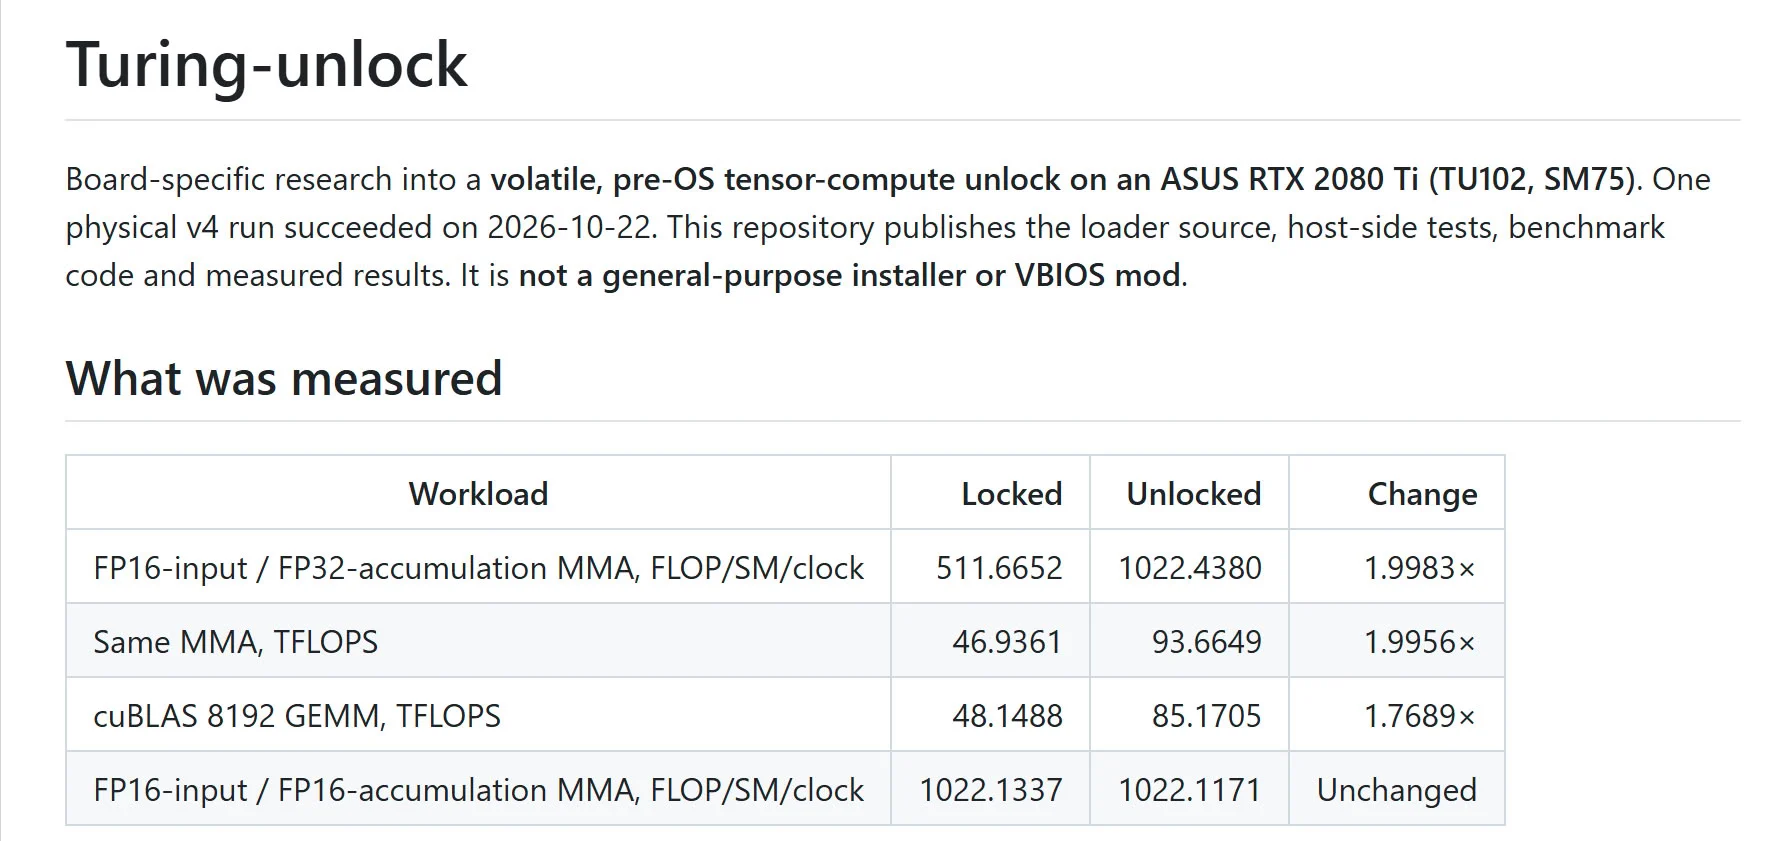
Nhưng TFLOPS đỉnh không phải đồng hồ đo tốc độ cho mọi ứng dụng. Trong phép thử nhân ma trận cuBLAS trên RTX 4090, mức tăng thực tế được ghi nhận chỉ khoảng 12–34% với FP16 và tối đa 20% với BF16. Trên GPU Ampere, xử lý dữ liệu đầu vào của mô hình ngôn ngữ (prefill) có thể nhanh hơn khoảng 14–36%, trong khi kết quả còn tùy card, phần mềm, giới hạn điện năng và tác vụ.
Vì vậy, benchmark là bằng chứng rằng giới hạn đã được nới, không phải lời hứa về hiệu năng ổn định trong mọi quy trình. FP16 BF16 GPU chỉ đem lại lợi ích rõ khi tác vụ thực sự dùng các phép toán được mở khóa và không bị một nút thắt khác chi phối.
Game và sinh token khó được lợi
Người chơi game không nên kỳ vọng thêm khung hình. Các công cụ tập trung vào tính toán AI và ma trận, còn game truyền thống, dựng hình thời gian thực và tốc độ khung hình không được hưởng lợi theo các báo cáo hiện có. Đây không phải một tinh chỉnh đồ họa tổng quát, nên điểm Tensor cao hơn không đồng nghĩa game chạy nhanh hơn.
Với mô hình ngôn ngữ chạy cục bộ, lợi ích cũng tập trung vào khâu phù hợp. Prefill có thể cải thiện, nhưng giai đoạn sinh từng token thường bị giới hạn bởi băng thông bộ nhớ—thứ các công cụ này không tăng cường—nên tốc độ decode được ghi nhận gần như không đổi.
Điều đó khiến việc mở khóa hấp dẫn nhất với người làm thử nghiệm AI, xử lý ma trận hoặc tạo ảnh bằng mô hình cục bộ, chứ không phải người chỉ muốn máy chơi game nhanh hơn. Nếu tác vụ chủ yếu chờ dữ liệu từ bộ nhớ, tăng tốc phép tính FP16/BF16 sẽ không giải quyết được nút thắt chính.
Rủi ro cao, hỗ trợ còn hạn chế
Đổi lại mức tăng benchmark là một quy trình thử nghiệm, phần lớn hướng đến Linux và đòi hỏi cấu hình thủ công lúc khởi động. Tài liệu dự án cảnh báo về khả năng hệ thống mất ổn định, khởi động thất bại, hỏng dữ liệu hoặc hư hại phần cứng; can thiệp cũng có thể làm mất bảo hành. Đây là rủi ro thực tế, không phải dòng cảnh báo có thể bỏ qua.
Phạm vi tương thích cũng chưa đồng đều: có công cụ cho một số card RTX 20, 30 và 40 series, nhưng việc một mẫu hoạt động không đảm bảo mẫu khác cùng thế hệ cũng tương thích. RTX 50 series hiện chưa được hỗ trợ hoặc xác nhận có cách mở khóa.
Kết luận: đây là một phát hiện kỹ thuật đáng quan tâm và có thể hữu ích cho người dùng AI cục bộ sẵn sàng chấp nhận thử nghiệm. Nhưng với đa số chủ GeForce, mức tăng trên biểu đồ không đủ để đánh đổi bảo hành, độ ổn định và công sức cấu hình. Hãy xem nó là dự án thử nghiệm, không phải bản nâng cấp đáng tin cậy hay giải pháp tăng tốc game.