
Hai mô hình nhỏ, hai mục tiêu khác nhau
Mô hình AI nhỏ là hệ thống có ít tham số hơn các mô hình lớn, được thiết kế để xử lý những tác vụ chuyên biệt với yêu cầu triển khai nhẹ hơn, thay vì cạnh tranh trên mọi năng lực cùng lúc. Hai checkpoint khoảng 2 tỷ tham số của Liquid AI minh họa rõ cách tiếp cận ấy: LFM3-VL-2B hướng đến hiểu hình ảnh và video, trong khi d1-Omni-2B được tinh chỉnh để đưa ra quyết định có cấu trúc. LFM3-VL-2B xuất hiện trên Hugging Face ngày 19 tháng 10 năm 2026; Liquid AI công bố dòng LFM3 ngày 27 tháng 10. Repo d1-Omni-2B được tạo ngày 24 tháng 10, rồi được nhắc tên trong đợt công bố ngày 27 tháng 10. Mấu chốt không phải là một mô hình thắng mô hình kia, mà là hiệu năng phải được đọc theo đúng tác vụ và phép đo.
Liquid AI định vị LFM3-VL-2B là thành viên thị giác của gia đình sáu mô hình trên nền tảng chung 1,7 tỷ tham số. Hai checkpoint cùng mang nhãn 2B nhưng không thể xem là hai phiên bản thay thế: một mô hình tạo câu trả lời bằng văn bản sau khi nhận nội dung thị giác; mô hình kia trả về lựa chọn, điểm số hoặc giá trị có cấu trúc để phục vụ quyết định.
LFM3-VL-2B: điểm cao, nhưng chế độ suy luận có giá của nó
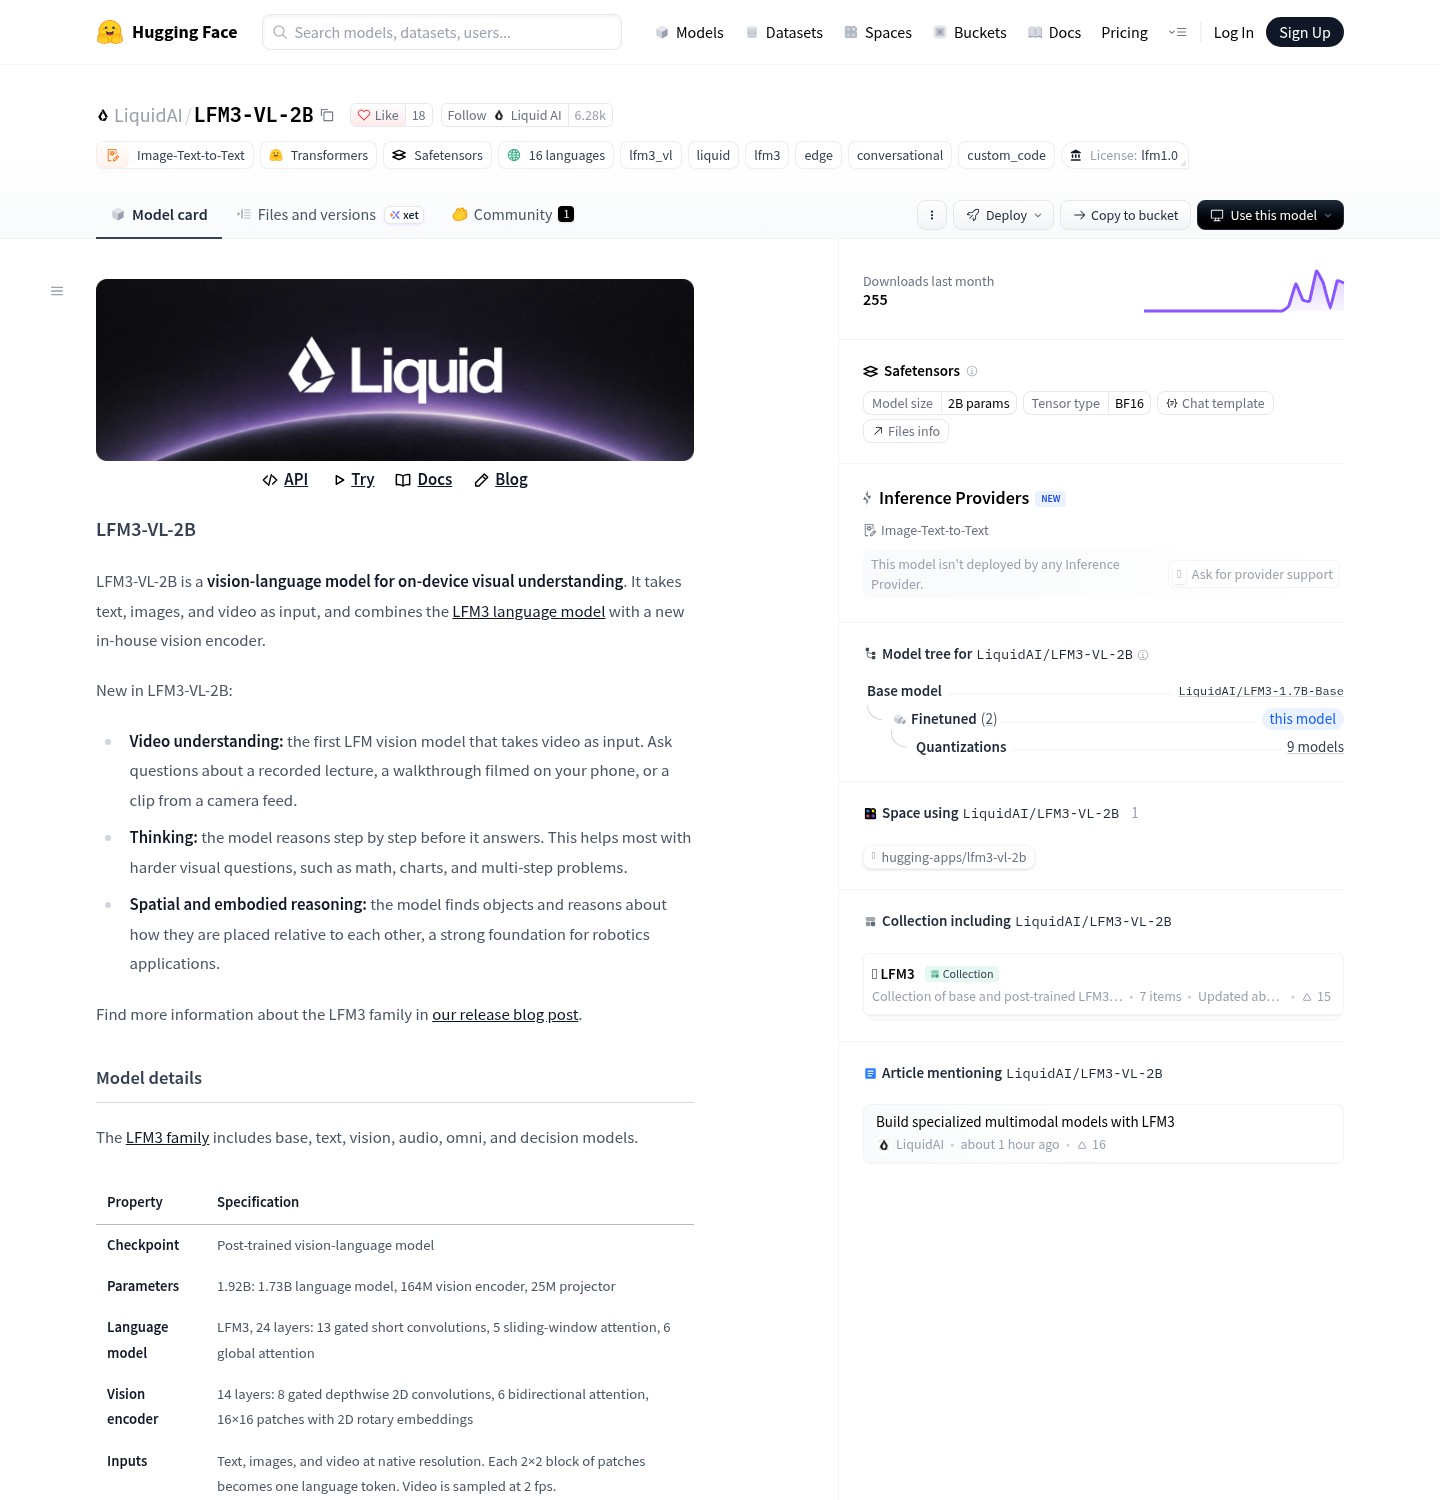
LFM3-VL-2B có tổng cộng 1,92 tỷ tham số: mô hình ngôn ngữ 1,73 tỷ, bộ mã hóa thị giác 164 triệu và bộ chiếu 25 triệu. Trên 62 benchmark thị giác do Liquid AI tổng hợp, mô hình đạt trung bình 71,4 điểm, cao hơn 57,6 của LFM2.5-VL-3B dù mô hình mới có ít tham số hơn. Nhưng điểm 71,4 đi kèm chế độ suy luận; khi tắt chế độ này, kết quả giảm còn 62,1. Khoảng cách 9,3 điểm đáng lưu ý với người triển khai: hiệu năng cao nhất không phải mặc định miễn phí về thời gian xử lý. Nhà phát triển ứng dụng phải cân nhắc liệu phần cải thiện có đáng với độ trễ của vòng suy luận hay không, nhất là khi mô hình chạy trên thiết bị.
Điểm trung bình cũng che khuất khác biệt giữa các nhóm tác vụ. Hạng mục tài liệu, OCR và biểu đồ đạt 83,9, một kết quả có ý nghĩa thực tế với xử lý giấy tờ và giao diện. Tuy nhiên, thẻ mô hình không khuyến nghị dùng LFM3-VL-2B cho lập trình, hội thoại nhiều lượt hay suy luận phức tạp. Vì vậy, con số benchmark thị giác nổi bật không nên bị diễn giải thành năng lực tổng quát ngang một mô hình trò chuyện.
d1-Omni-2B: đo khả năng quyết định, không đo chất lượng trò chuyện
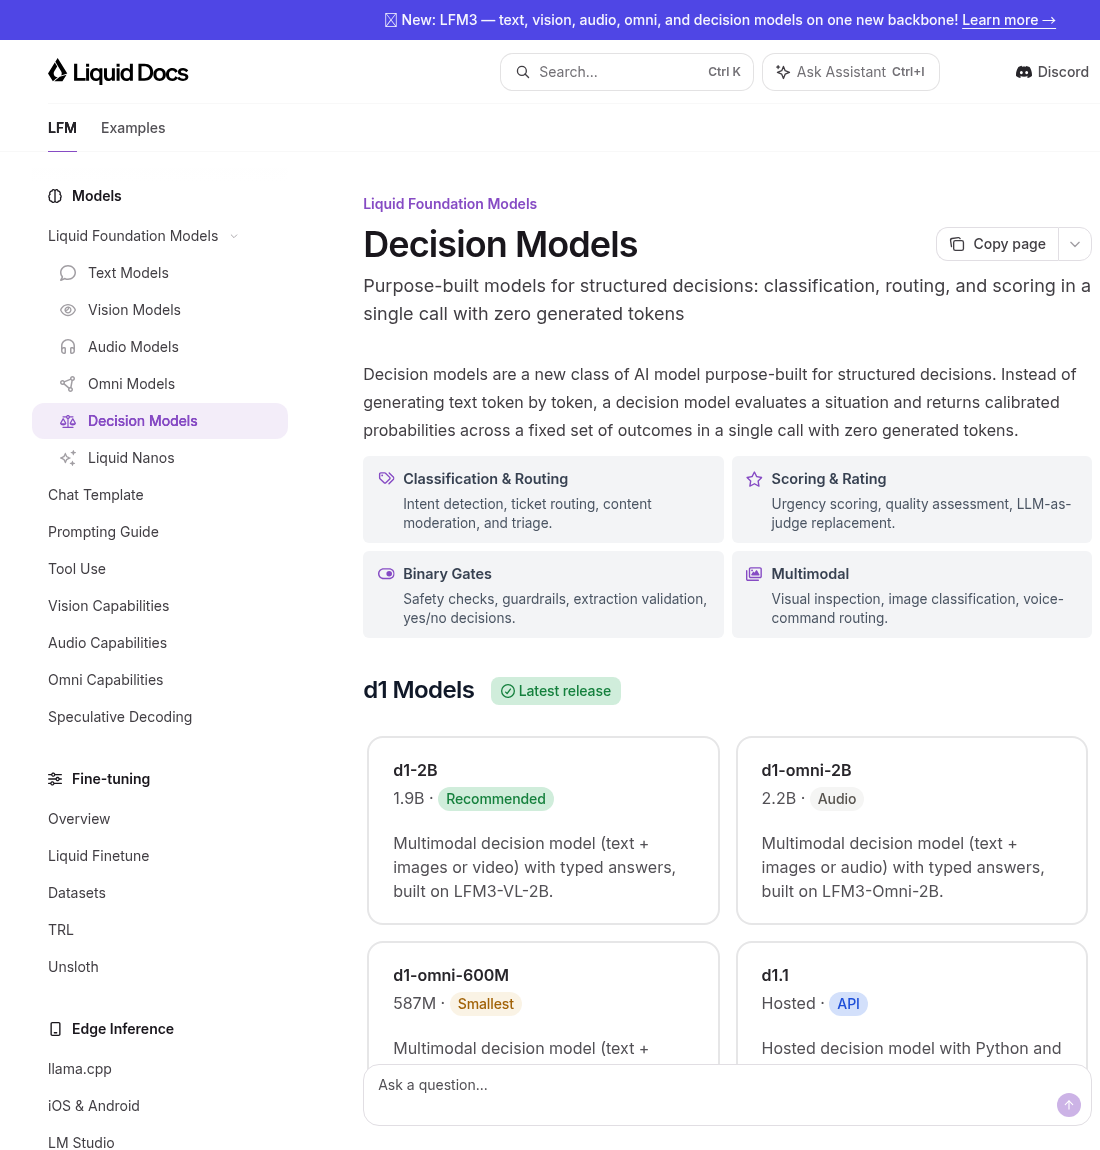
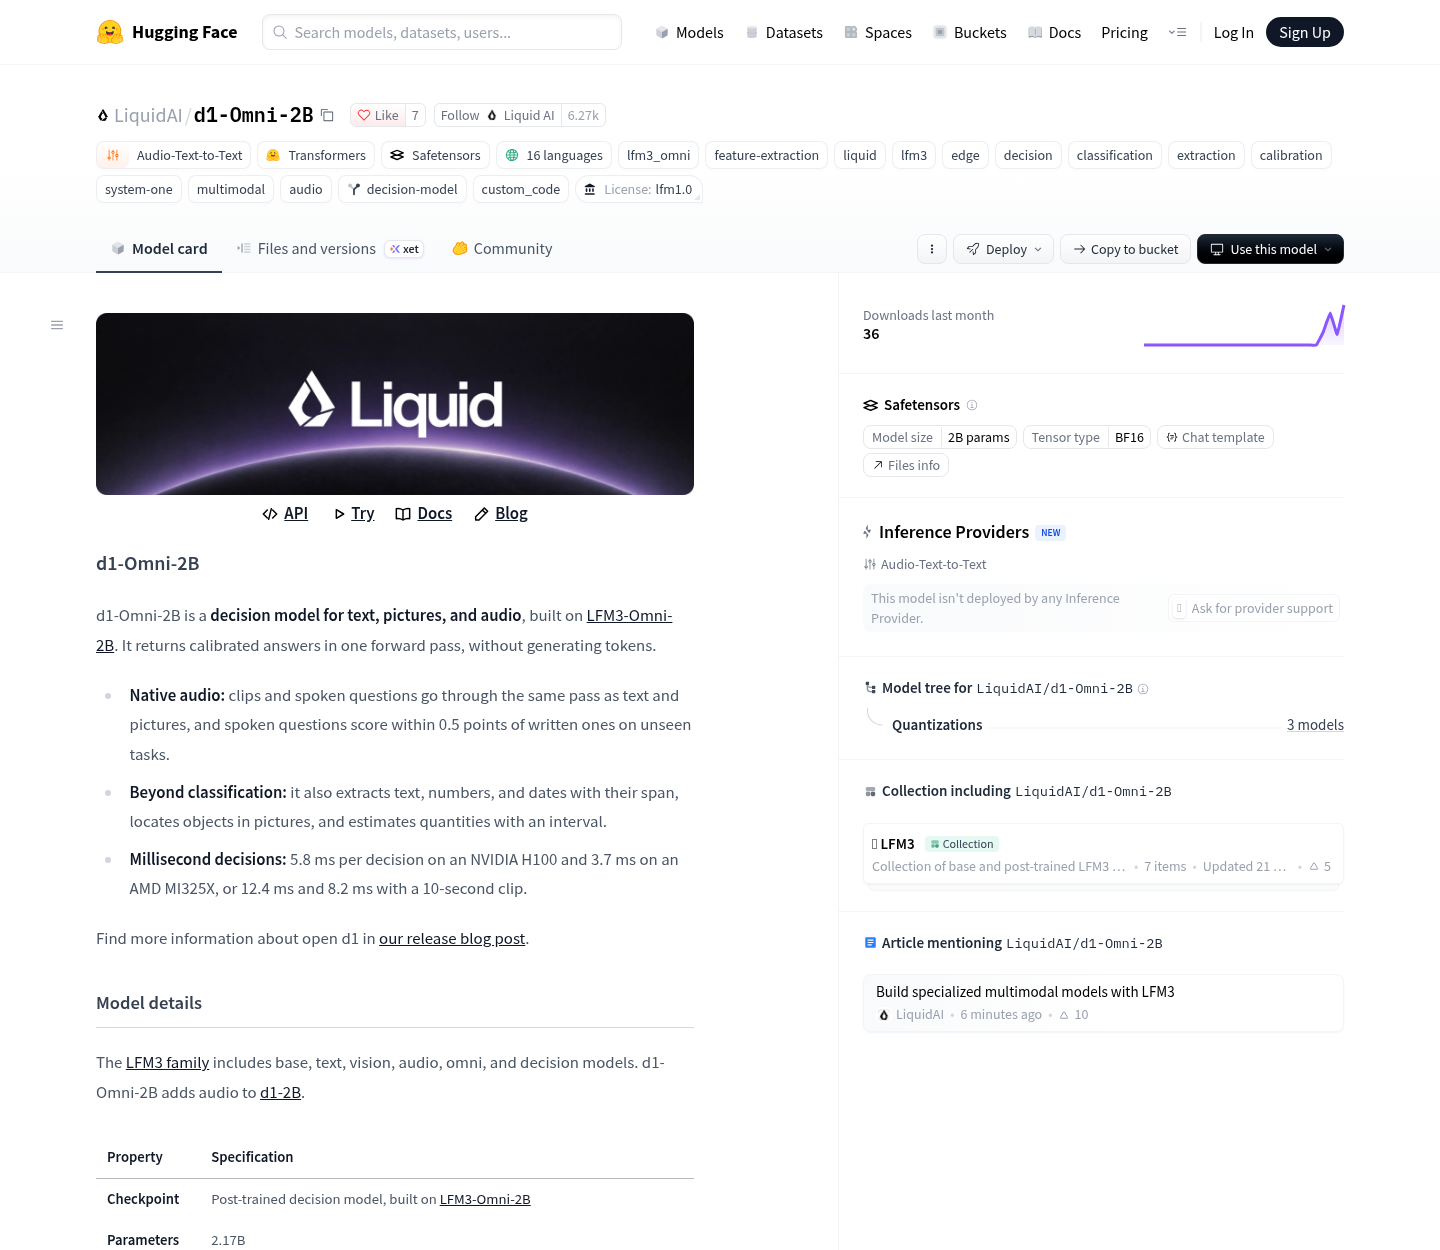
d1-Omni-2B có 2,17 tỷ tham số, được huấn luyện hậu kỳ trên LFM3-Omni-2B và không phải mô hình trò chuyện. Thay vì viết văn bản hay tạo giọng nói, nó nhận trạng thái dạng văn bản hoặc JSON cùng các dữ liệu như hình ảnh, khung hình video, âm thanh và câu hỏi; đầu ra là câu trả lời có kiểu dữ liệu kèm xác suất. Các dạng đầu ra được mô tả gồm có/không, lựa chọn từ danh sách, điểm có thứ tự, giá trị trích từ tài liệu, khoảng số, hộp giới hạn hoặc số lượng đối tượng. Đây là thiết kế hướng đến tác vụ ra quyết định, nên so điểm trực tiếp với benchmark thị giác của LFM3-VL-2B sẽ đánh đồng hai việc khác nhau.
Trên Decision Index công khai phiên bản 0.3, d1-Omni-2B đạt 49,0 điểm: ngang d1-3B, thấp hơn d1-2B ở mức 51,1 và cao hơn nhiều d1-omni-600M với 18,3. Kết quả này cho thấy quy mô 2B không tự động tạo lợi thế trong mọi phép đo. Nó cũng cần được đặt trong bối cảnh nguồn: đây là điểm do nhà cung cấp công bố, chưa có benchmark độc lập được nêu. Kho lưu trữ có trọng số và tài liệu, nhưng bản công bố chưa đưa ra giá, endpoint lưu trữ hay đánh giá độc lập.
Quy mô nhỏ có ý nghĩa khi tác vụ và cách triển khai phù hợp
Hai mô hình củng cố một luận điểm đáng chú ý nhưng có điều kiện: giảm số tham số không đồng nghĩa phải chấp nhận hiệu năng yếu, miễn là mô hình được tối ưu cho đúng việc. LFM3-VL-2B vượt mô hình thị giác tiền nhiệm lớn hơn trên bộ benchmark của Liquid AI, còn d1-Omni-2B gói khả năng quyết định đa phương thức vào checkpoint 2,17 tỷ tham số. Tuy nhiên, phép so sánh giữa chúng dừng ở quy mô và mục tiêu triển khai; 71,4 trên 62 bài kiểm tra thị giác không thể đặt cạnh 49,0 trên Decision Index như thể đó là cùng một thang điểm.
Với người dùng, lợi ích tiềm năng nằm ở khả năng đưa xử lý chuyên biệt lên thiết bị hoặc vào quy trình nhỏ hơn, thay vì phải gọi một mô hình lớn cho mọi bước. Nhưng giới hạn cũng cụ thể: LFM3-VL-2B mất điểm đáng kể khi tắt suy luận và không được khuyến nghị cho một số tác vụ ngôn ngữ; d1-Omni-2B không tạo hội thoại, còn kết quả hiện được dẫn chủ yếu là tự đánh giá của nhà cung cấp. Hỗ trợ llama.cpp cho LFM3-VL-2B đang được xem xét, song tài liệu được trích dẫn lưu ý hiện chưa có đầu vào video trong hỗ trợ đó.
Kết luận hợp lý không phải rằng mô hình nhỏ đã thay thế mô hình lớn, mà là Liquid AI đang chứng minh giá trị của chuyên môn hóa ở quy mô khoảng 2B. LFM3-VL-2B đáng chú ý với thị giác, còn d1-Omni-2B đáng theo dõi cho quyết định có cấu trúc. Trước khi xem các điểm số như bằng chứng cuối cùng, người dùng vẫn cần kiểm tra độ trễ, khả năng tích hợp và đánh giá độc lập.