
Benchmark là phép đo, không phải quyết định mua
Benchmark mô hình AI là phép thử chuẩn hóa dùng để đo khả năng của các hệ thống trên cùng một nhóm nhiệm vụ, nhưng điểm số chỉ hữu ích khi phản ánh đúng công việc bạn cần giao cho mô hình. Đó là lý do không nên chọn theo thứ hạng đơn lẻ: một mô hình dẫn điểm có thể tốn kém hơn, còn lựa chọn hợp lý phụ thuộc vào giá trị của câu trả lời đúng, tốc độ và cách truy cập. Trong so sánh GPT với các đối thủ, cần tách năng lực trên bài thi khỏi hiệu quả vận hành. Điểm VMMU chẳng hạn, đo khả năng kết hợp tiếng Việt với bằng chứng hình ảnh; chỉ số trí tuệ khác lại bao quát một tập nhiệm vụ khác. Hai kết quả không thể thay thế nhau, và cũng không nói trước chắc chắn mô hình nào phù hợp với quy trình cụ thể.
VMMU cho thấy lợi thế của Gemini tập trung ở một số dạng hình ảnh
Trên 2.548 câu hỏi tiếng Việt cần kết hợp văn bản với hình ảnh, Gemini 3 Pro đạt 86,33%, còn GPT-5 đạt 78,41% — khoảng cách 7,92 điểm phần trăm. Đây là lợi thế có ý nghĩa nếu công việc đòi hỏi đọc biểu đồ, sơ đồ, bản đồ hoặc biển báo, nhưng điểm trung bình che đi khác biệt giữa các lĩnh vực. Khoảng cách lớn nhất xuất hiện ở phần lái xe: 91,28% so với 75,20%; phần IQ về quy luật hình và quan hệ không gian cũng chênh rõ, với 72,08% so với 58,75%. Ngược lại, ở toán học, hai mô hình gần nhau hơn, lần lượt đạt 92,54% và 91,23%. Vì VMMU cho mỗi lĩnh vực trọng số ngang nhau dù số câu khác biệt, kết quả tổng hợp không nhất thiết dự báo chính xác hiệu suất trong một quy trình có cơ cấu nhiệm vụ riêng. Nếu chọn mô hình cho xử lý ảnh tiếng Việt, hãy dùng VMMU để thiết kế phép thử gần với dữ liệu thực tế của mình.
Bốn điểm hơn chưa chắc bù được chi phí và độ trễ
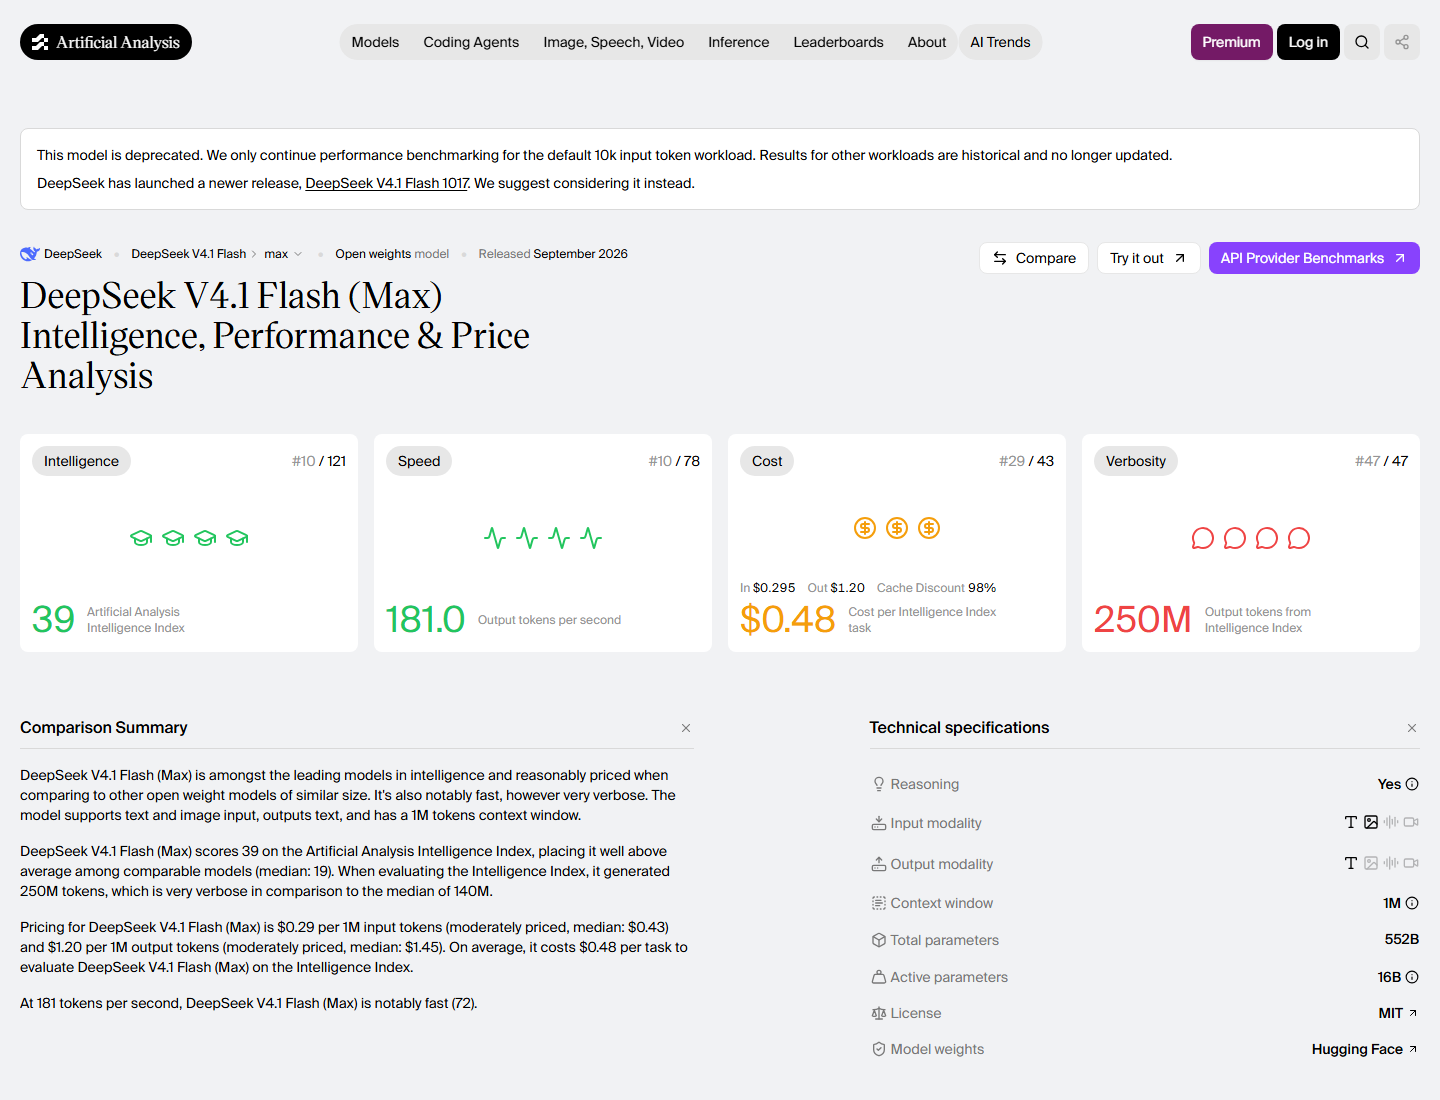
Ở phép so sánh chỉ số trí tuệ độc lập, Muse Wonder đạt 52 điểm, còn GPT-6.1 Terra đạt 48; mô hình mà nhà phát triển gọi được qua API hơn Terra bốn điểm, không phải tám. Bản có điểm cao hơn đi kèm chi phí mỗi tác vụ cao hơn đáng kể, nên chênh lệch điểm không tự động đồng nghĩa với lựa chọn kinh tế. Tốc độ lại đảo chiều một phần: Wonder tạo 207,8 token mỗi giây và mất khoảng 32 giây để có token đầu tiên, so với 90,9 token mỗi giây và gần 78 giây của Terra. Cả hai đều khởi động chậm nếu xét theo giá trị tuyệt đối; đó là đặc tính cần tính vào trải nghiệm, không phải lý do bỏ qua phép đo. Con số chi phí theo tác vụ trong nguồn đến từ một đánh giá do doanh nghiệp bán phần mềm kế toán thực hiện, nên đây là bằng chứng bên thứ ba có lợi ích thương mại, không phải kiểm toán trung lập. Hãy xem đó là manh mối cần kiểm chứng trên khối lượng công việc của bạn, không phải con số để thiết kế hệ thống cứng nhắc.
Chọn theo công việc và mức độ người dùng phải chờ
Với tác vụ phân loại, trích xuất, đọc biểu mẫu hoặc một bước tác tử có giới hạn, mô hình rẻ hơn là điểm xuất phát hợp lý; mô hình đắt hơn cần chứng minh rằng độ chính xác bổ sung tạo ra giá trị lớn hơn khoản chênh lệch vận hành. Trong xử lý theo lô qua đêm, độ trễ có thể ít quan trọng hơn chi phí. Còn ở sản phẩm tương tác, thời gian chờ token đầu tiên ảnh hưởng trực tiếp đến trải nghiệm, nên tốc độ có thể đáng để trả thêm. Việc sử dụng cũng khác nhau: Terra có thể gọi qua API, trong khi Muse Wonder có sự phân biệt giữa mô hình API và phiên bản điểm cao hơn chỉ nằm trong gói đăng ký, không phục vụ qua API. Vì vậy, hãy thử đúng phiên bản, đúng cách tích hợp và đúng loại đầu vào dự định triển khai; bảng xếp hạng không thay thế được phép thử đó.
- Mua nếu công việc là xử lý hàng loạt qua đêm và chi phí vận hành quan trọng hơn phản hồi tức thời.
- Bỏ qua Terra nếu sản phẩm tương tác không thể chấp nhận thời gian chờ token đầu tiên gần 78 giây; Wonder nhanh hơn ở phép đo này, dù vẫn khởi động chậm.
- Mua mô hình có điểm VMMU cao hơn nếu quy trình chủ yếu xử lý biển báo, tình huống giao thông hoặc câu hỏi hình ảnh tiếng Việt tương tự bài thi.
- Bỏ qua lựa chọn theo điểm tổng nếu tác vụ thực tế tập trung vào một lĩnh vực khác; hãy kiểm thử bằng dữ liệu và tỷ trọng nhiệm vụ của chính bạn.
Kết luận: benchmark cho biết nên bắt đầu thử ở đâu, không phải mô hình nào chắc chắn đáng tiền. Đặt điểm số cạnh chi phí mỗi tác vụ, tốc độ, phương thức sử dụng và mức thiệt hại khi mô hình trả lời sai; sau đó chọn phương án thắng trong chính quy trình của bạn.