
Một dòng mô hình, sáu hướng sử dụng
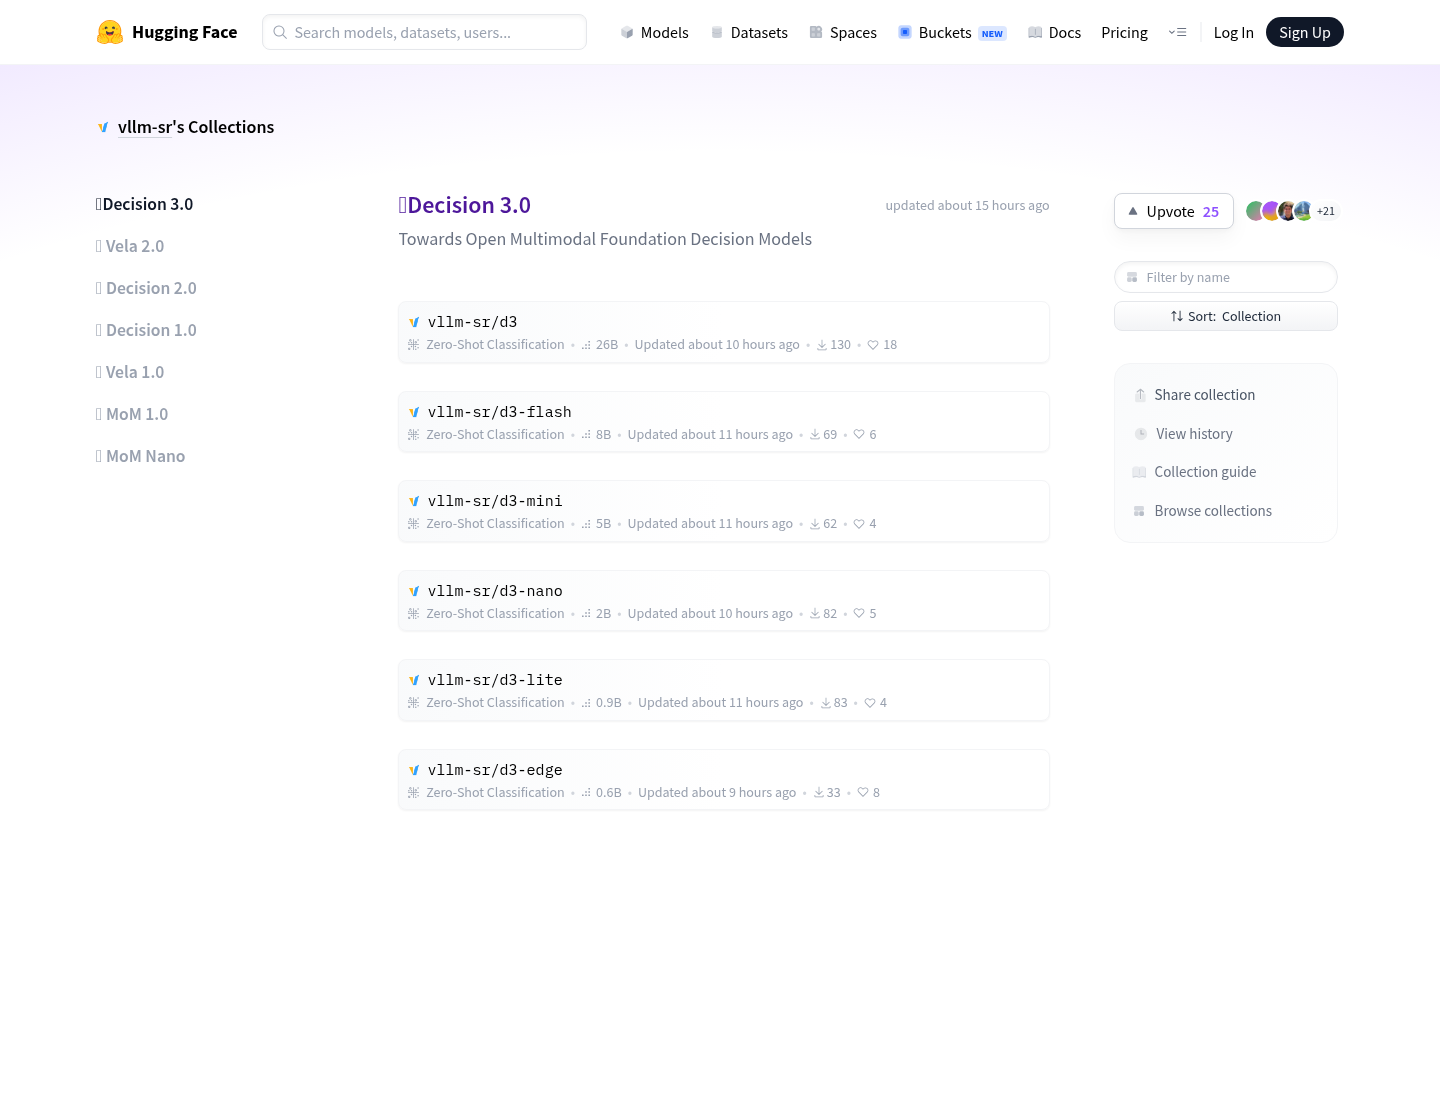
LFM3 là dòng mô hình nền tảng trọng số mở của Liquid AI, gồm sáu biến thể thuộc lớp 2B được xây dựng trên cùng một nền tảng để xử lý văn bản, hình ảnh, âm thanh, đầu vào đa phương thức và tác vụ ra quyết định. Công bố ngày 27 tháng 10 năm 2026, dòng sản phẩm này chọn nhiều mô hình chuyên biệt thay vì đặt cược vào một mô hình nhỏ đa năng duy nhất.
Cách chia này có ý nghĩa thực tế: người cần xử lý văn bản không phải mặc định dùng mô hình nghe, nhìn và nói; còn ứng dụng cần các phương thức đó có biến thể phù hợp. Liquid AI gọi định hướng ấy là “trí tuệ chuyên biệt”, một lựa chọn hợp lý nếu mỗi nhánh có thể làm tốt tác vụ cụ thể mà không buộc người dùng gánh thêm chức năng không cần thiết.
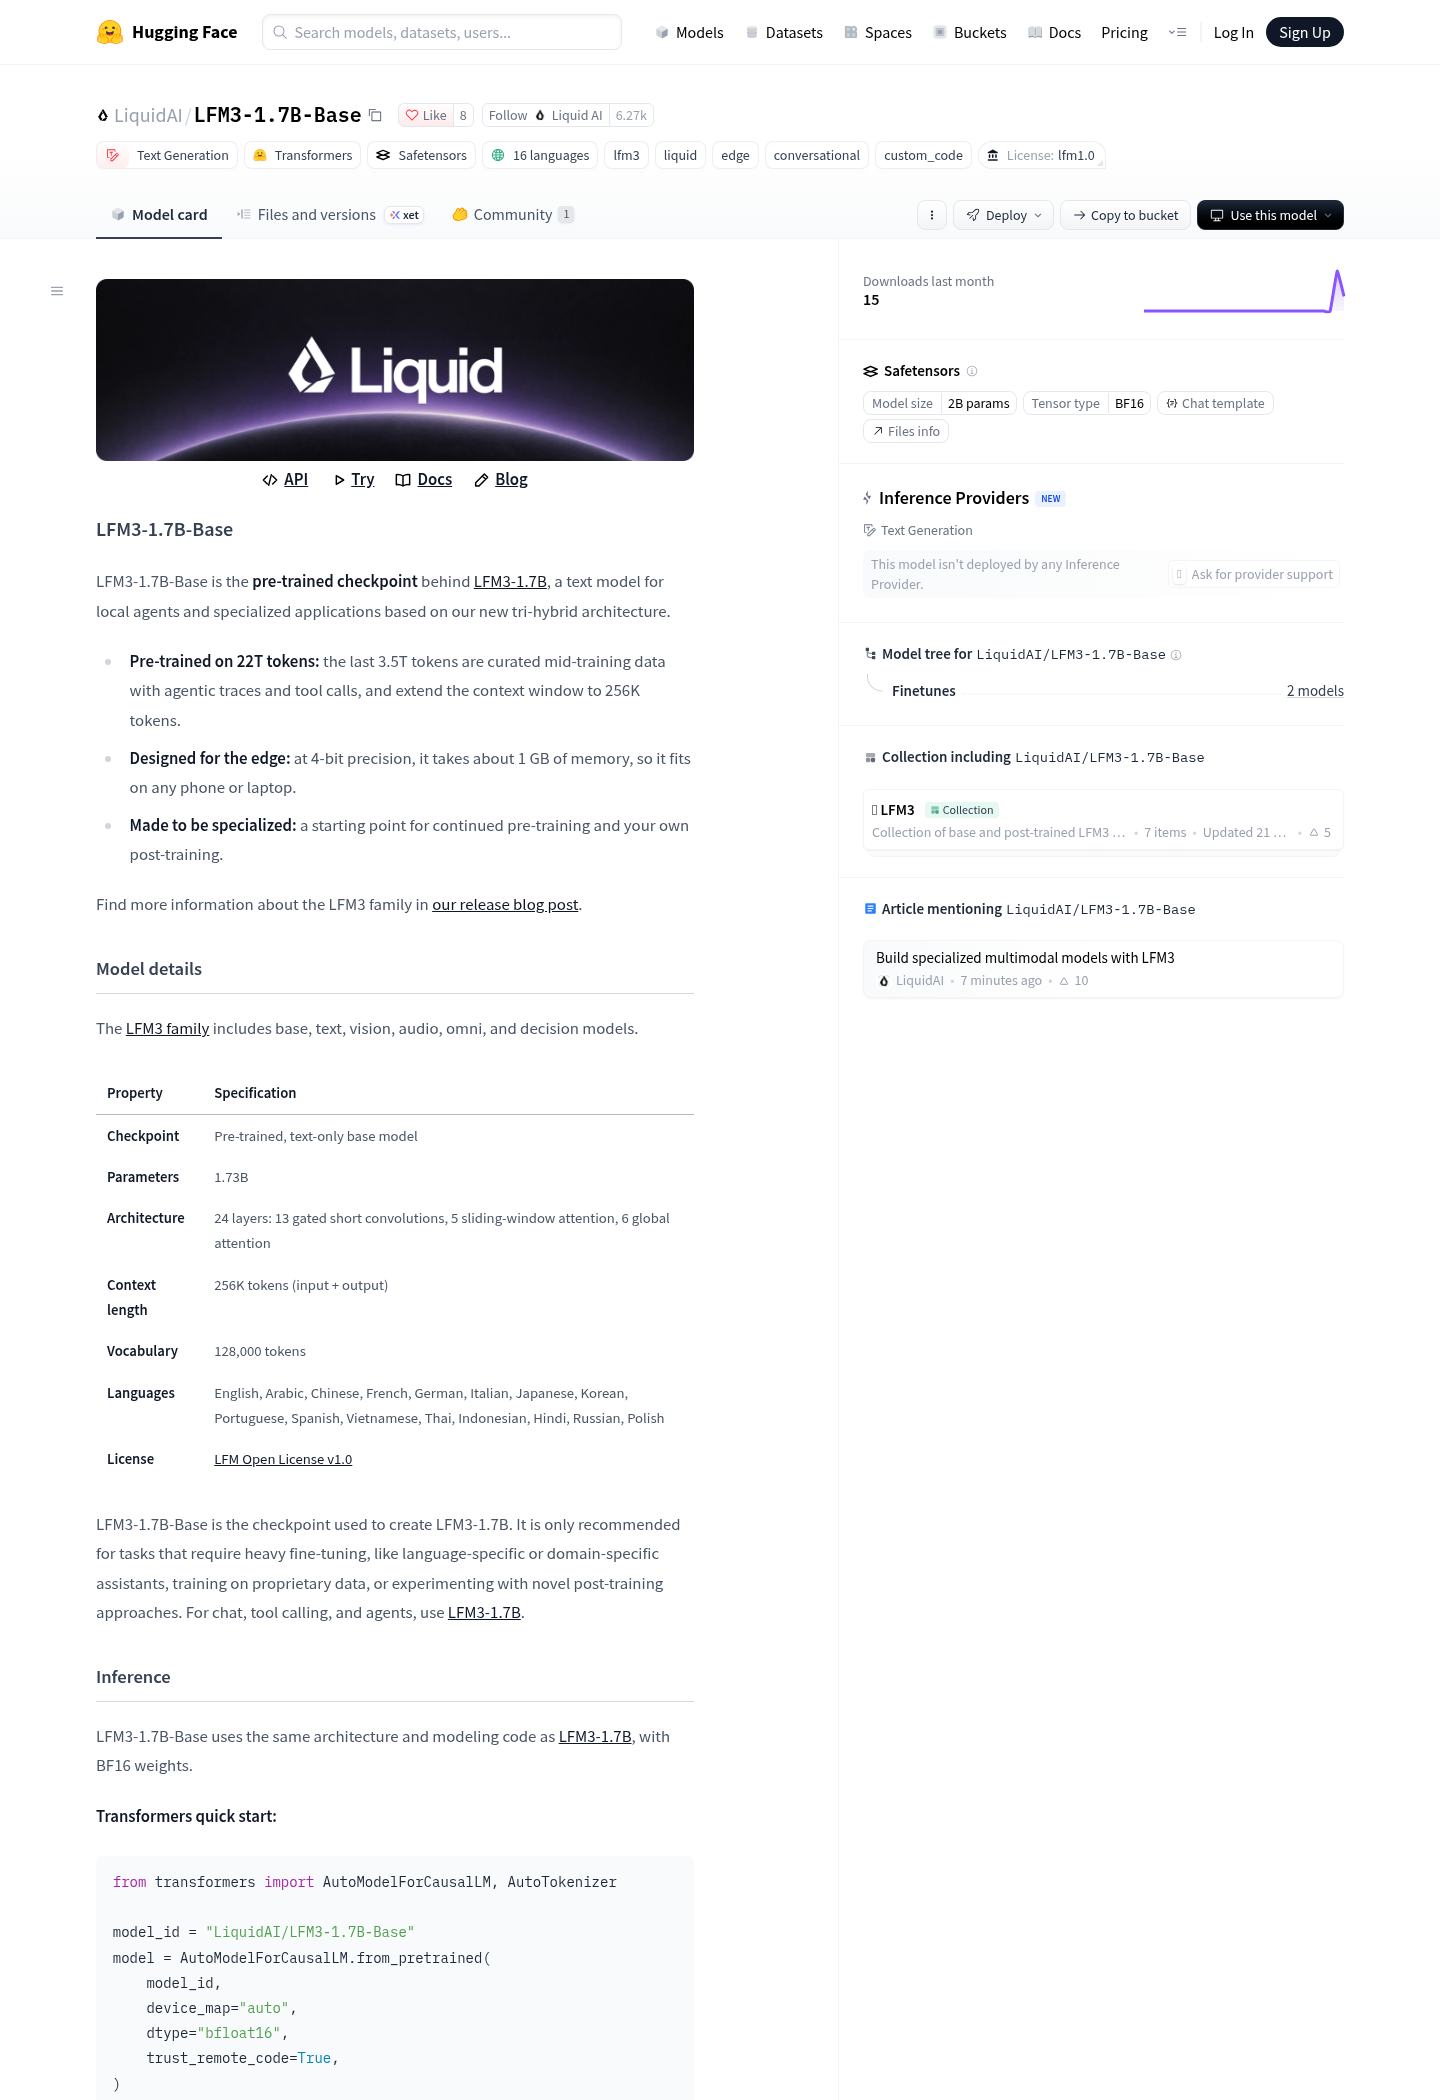
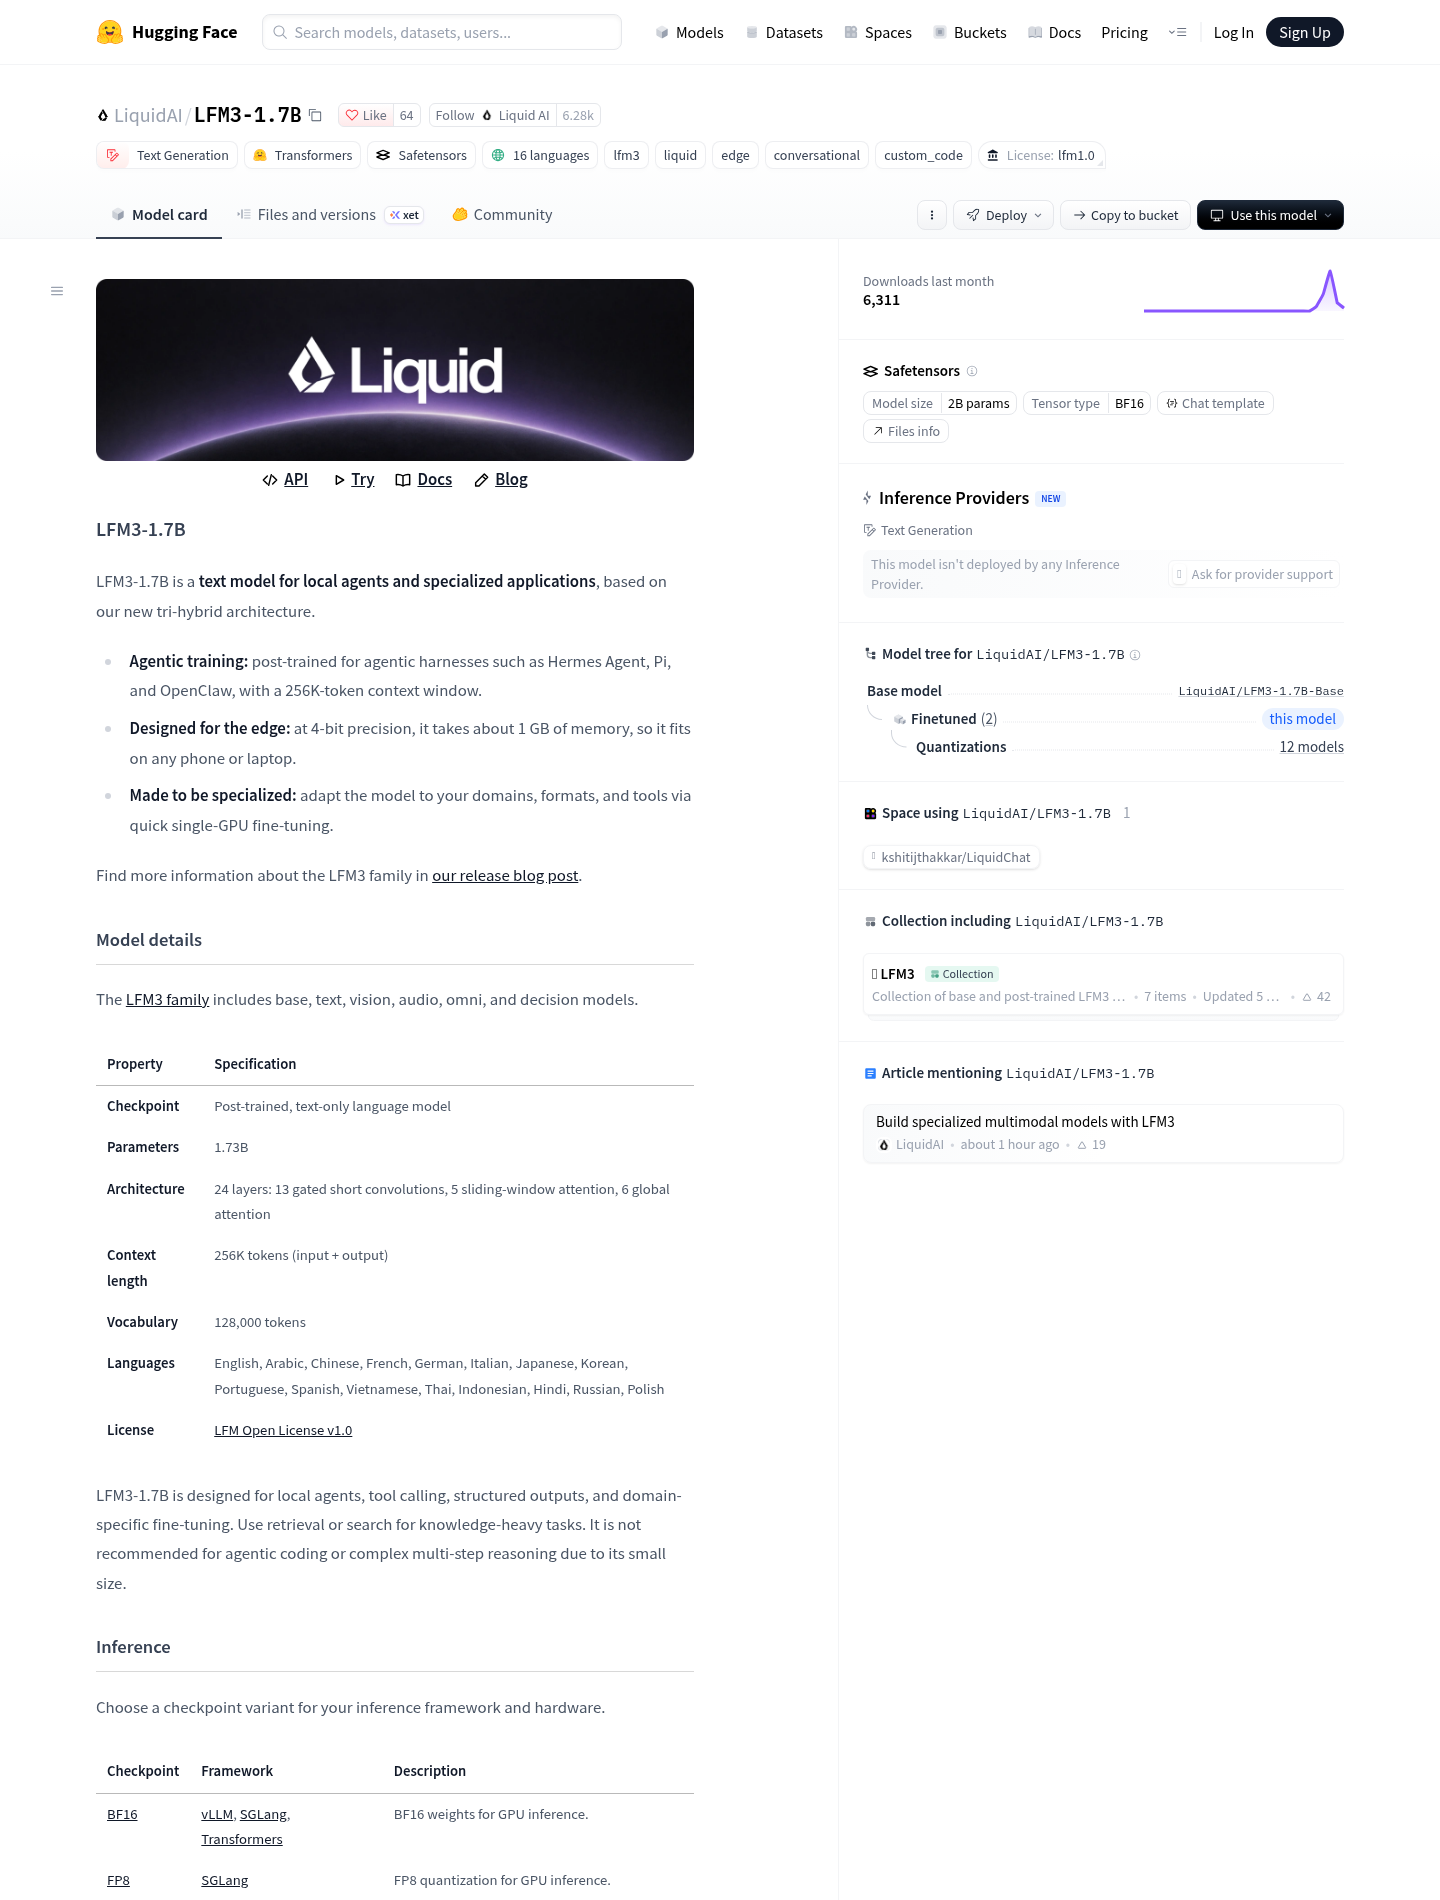
Cả mô hình nền tảng lẫn các bản đã qua huấn luyện hậu kỳ đều được phát hành với trọng số mở, qua Hugging Face, Liquid AI Playground và API của hãng. Với người dùng phổ thông, điểm đáng chú ý là lựa chọn không chỉ giới hạn ở dịch vụ trực tuyến: mô hình văn bản được cho là cần khoảng 1 GB bộ nhớ ở độ chính xác 4-bit, nên khả năng chạy cục bộ trên thiết bị nhỏ là một hướng triển khai đáng quan tâm.
Backbone tri-hybrid: dùng chung không có nghĩa là giống hệt
Sáu biến thể bắt nguồn từ LFM3-1.7B-Base, nhưng khác nhau ở cách tiếp nhận đầu vào, tạo đầu ra và tinh chỉnh cho từng nhiệm vụ. Backbone của mô hình cơ sở có 24 lớp: 13 lớp tích chập ngắn có cổng, năm lớp chú ý cửa sổ trượt và sáu lớp chú ý toàn cục. Cách phối hợp này là điểm kiến trúc đáng chú ý hơn con số tham số: tích chập xử lý cấu trúc cục bộ, còn các lớp chú ý kết nối thông tin ở khoảng cách xa.
Cần phân biệt cửa sổ chú ý trượt 256 token với độ dài ngữ cảnh. Theo tài liệu được nêu cho LFM3-1.7B-Base và mô hình văn bản, ngữ cảnh là 256K token, tính cả đầu vào và đầu ra; con số 256 token mô tả phạm vi của một lớp chú ý, không phải giới hạn toàn mô hình. Quan trọng hơn, không nên tự động gán ngữ cảnh 256K cho mọi biến thể: thông tin chính thức được dẫn chỉ xác nhận con số này cho mô hình cơ sở và mô hình văn bản, chứ không công bố cửa sổ của bốn nhánh còn lại.
Liquid cho biết thiết kế xuất phát từ quá trình tìm kiếm kiến trúc có phần cứng trong vòng lặp, mở rộng trên 14 tổ hợp thiết bị và phần phụ trợ. Đây là lý do đáng để theo dõi: backbone chung có thể giúp hệ mô hình thích nghi với nhiều môi trường triển khai, nhưng không chứng minh rằng mỗi biến thể có cùng tốc độ, mức tiêu thụ bộ nhớ hay hiệu năng.
Sáu biến thể làm sáu việc khác nhau
Tên gọi cho biết khá rõ nên bắt đầu từ đâu, nhưng cũng cần tránh xem sáu mô hình như sáu cấp hiệu năng. Đây là các nhánh ngang hàng, được tinh chỉnh cho giao diện và kiểu tác vụ khác nhau; kết quả của một nhánh không thể đại diện cho cả dòng.
| Biến thể | Đầu vào và đầu ra | Vai trò chính |
|---|---|---|
| LFM3-1.7B | Văn bản vào, văn bản ra | Ngôn ngữ, tác tử và gọi công cụ |
| LFM3-VL-2B | Văn bản, hình ảnh, video vào; văn bản ra | Thị giác-ngôn ngữ |
| LFM3-Audio-2B | Văn bản hoặc âm thanh vào; văn bản hoặc lời nói ra | Nhận dạng, hiểu và tạo giọng nói |
| LFM3-Omni-2B | Văn bản, hình ảnh, video, âm thanh vào; văn bản và lời nói ra | AI đa phương thức |
| d1-2B | Nhánh thị giác; câu trả lời có cấu trúc | Ra quyết định với đầu ra đã hiệu chuẩn |
| d1-omni-2B | Nhánh đa phương thức; câu trả lời có cấu trúc | Ra quyết định trên đầu vào đa phương thức |
LFM3-VL xử lý hình ảnh và video, còn LFM3-Audio tập trung vào âm thanh và lời nói. LFM3-Omni là mô hình AI đa phương thức đầu tiên mà Liquid AI mô tả, kết hợp văn bản, hình ảnh, video và âm thanh. Hai biến thể d1 khác ở mục tiêu đầu ra: chúng trả lời theo dạng quyết định đã hiệu chuẩn thay vì tạo văn xuôi. Vì thế, khi đánh giá hay chọn mô hình LFM3, câu hỏi nên là “nhánh nào phù hợp với đầu vào và đầu ra của ứng dụng?” chứ không phải “mô hình nào đứng đầu cả dòng?”.
Benchmark cần được đọc cùng chế độ suy luận
Điểm benchmark là tín hiệu ban đầu, không phải bằng chứng độc lập về năng lực triển khai. Các số liệu được nêu trong nguồn do Liquid AI tạo trên bộ công cụ đánh giá của chính hãng và chưa được tái lập độc lập. Điều đó không khiến chúng vô giá trị, nhưng buộc người đọc phải xem phương pháp đo, thiết lập và biến thể được thử trước khi khái quát kết quả.
Chế độ suy luận cũng quan trọng: điểm số phụ thuộc vào cách mô hình được yêu cầu suy nghĩ, số bước được phép thực hiện và việc có dùng công cụ hay không. Hồ sơ được mô tả cho thấy khả năng tuân thủ chỉ dẫn mạnh và gọi công cụ trong một lượt ở mức khá, nhưng giảm rõ khi tác vụ cần nhiều bước tuần tự. Riêng Terminal-Bench 2.1 đạt 12,92 và SWE-bench Multilingual đạt 23,00; các mức này không đủ để kết luận LFM3 là tác nhân lập trình tự chủ.
Kết luận thận trọng là nên xem điểm số như mô tả cho một cấu hình cụ thể, không phải giấy chứng nhận cho toàn bộ sáu mô hình. Tiếp theo, điều cần chờ là các phép đo do bên độc lập thực hiện trên những bộ kiểm thử và thiết lập khác nhau. LFM3 có một câu chuyện kiến trúc rõ ràng; câu hỏi còn mở là liệu ưu thế được tuyên bố có đứng vững ngoài bộ đánh giá do chính nhà phát triển xây dựng hay không.