
Một dòng mô hình nhỏ, nhiều nhiệm vụ
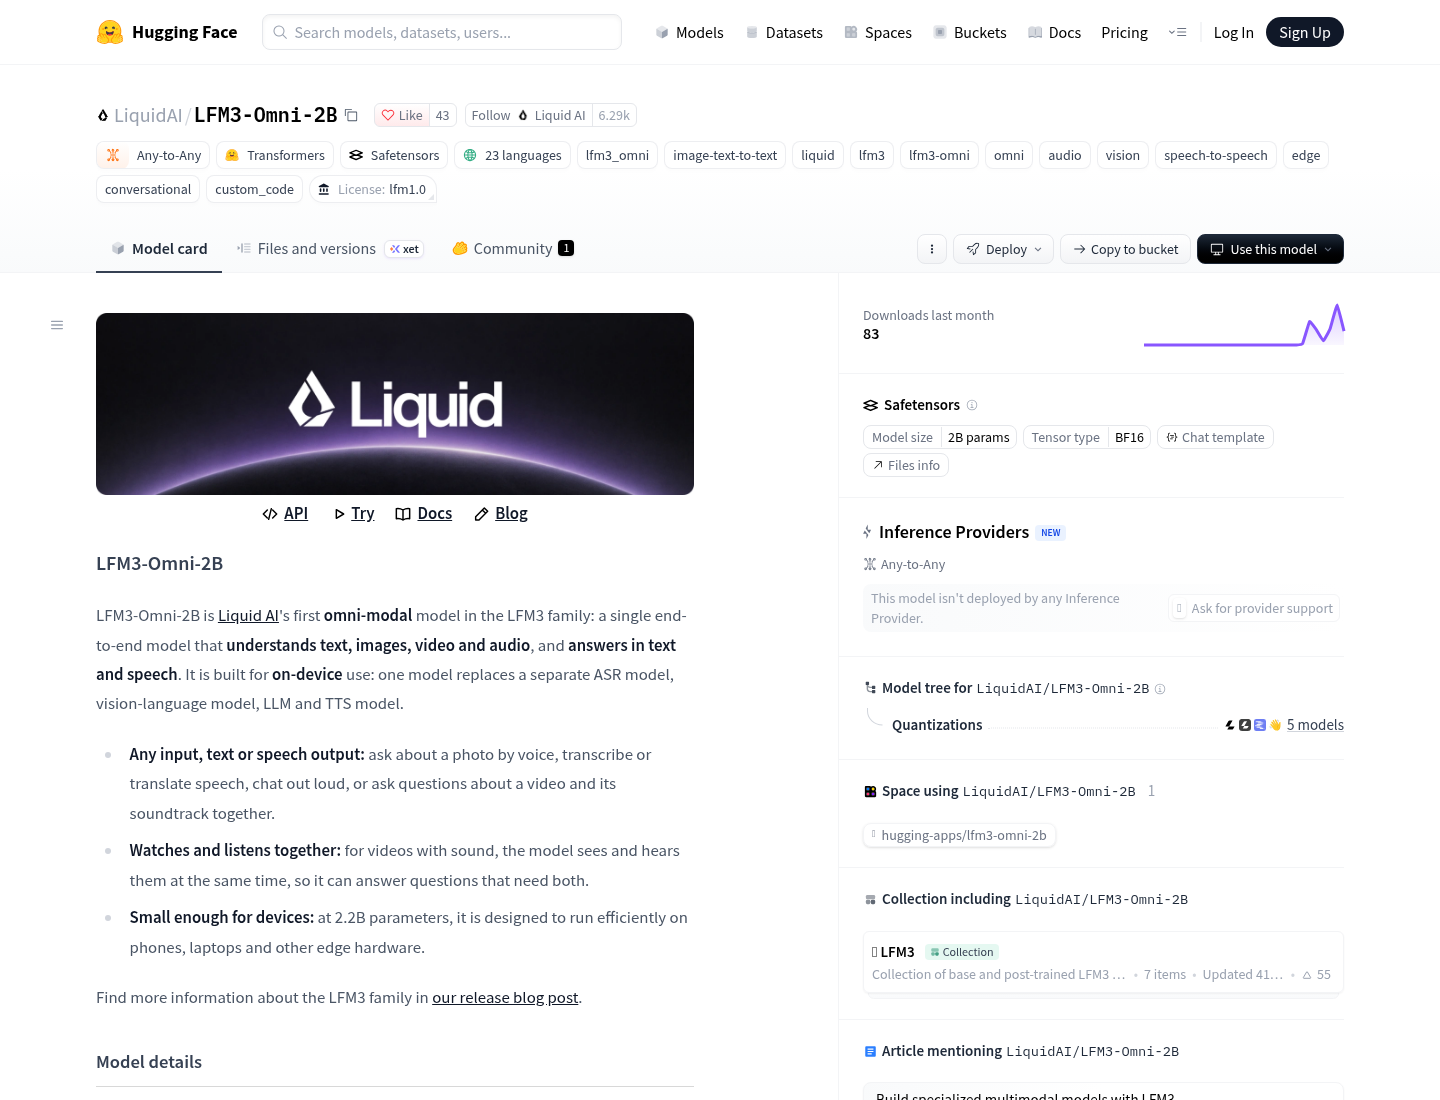
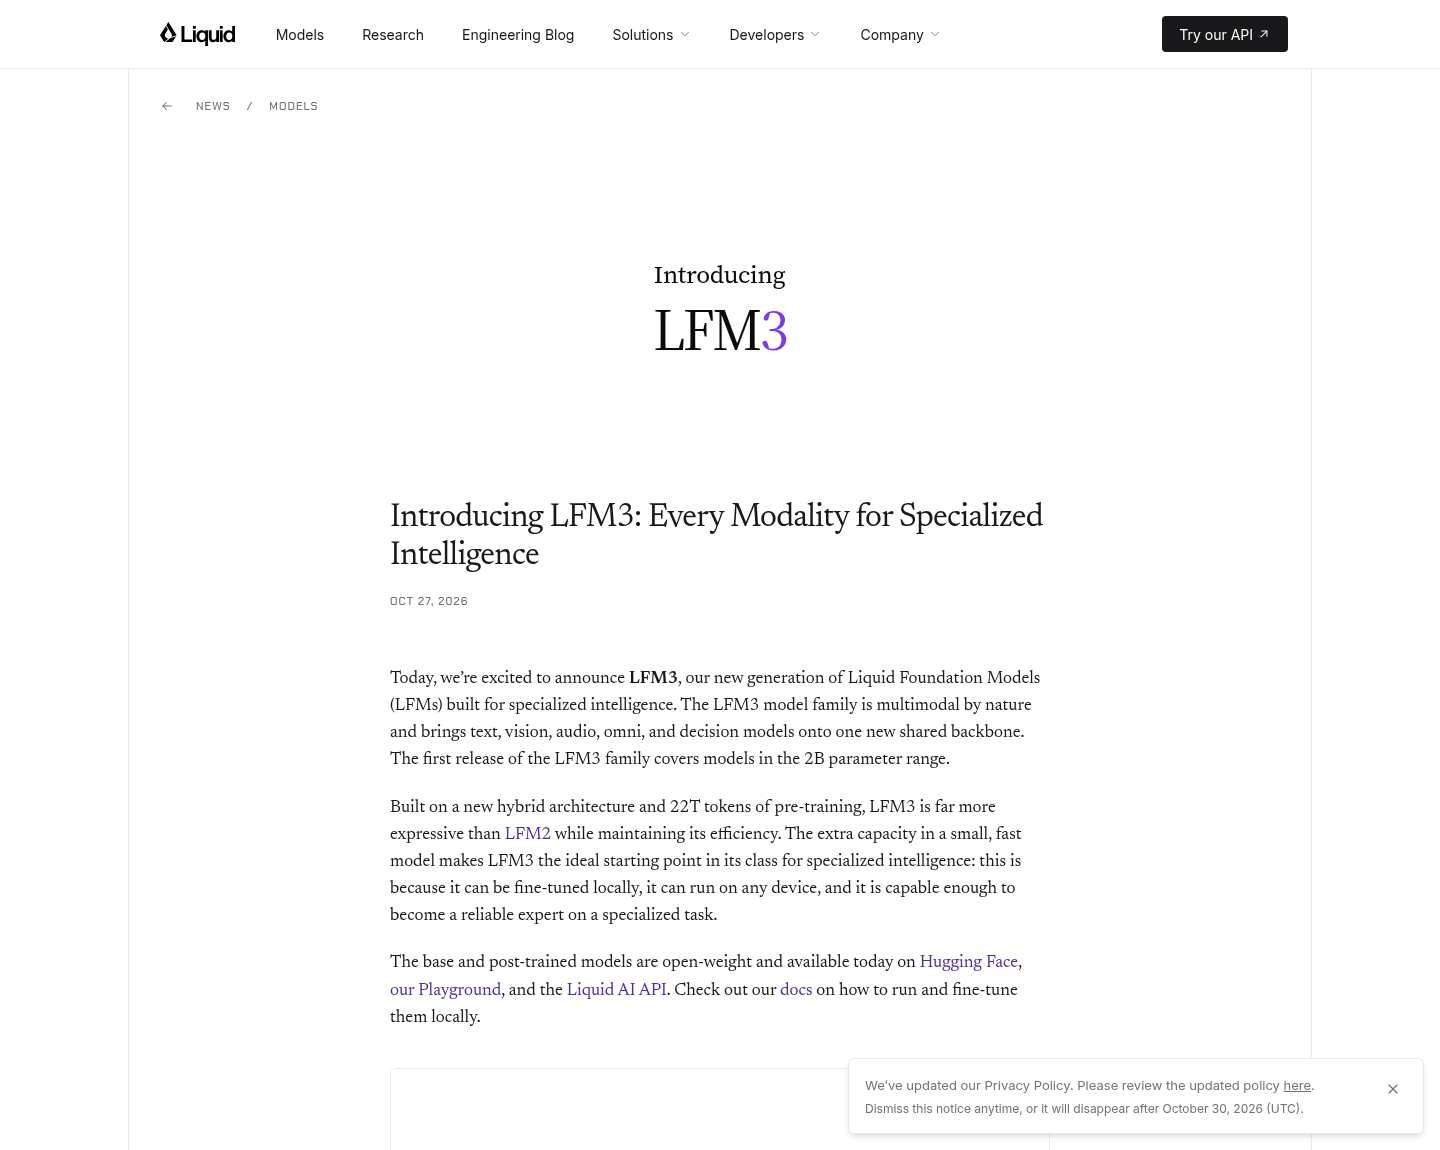
LFM3 là dòng mô hình nền tảng có trọng số mở của Liquid AI, gồm các biến thể cỡ nhỏ được thiết kế để xử lý văn bản, hình ảnh, âm thanh, video và tác vụ ra quyết định trên cùng một nền tảng kỹ thuật. Ngày 27 tháng 10 năm 2026, Liquid AI công bố sáu mô hình thuộc lớp 2B, chọn cách phát hành nhiều chuyên gia thay vì đặt cược vào một mô hình tổng quát duy nhất.
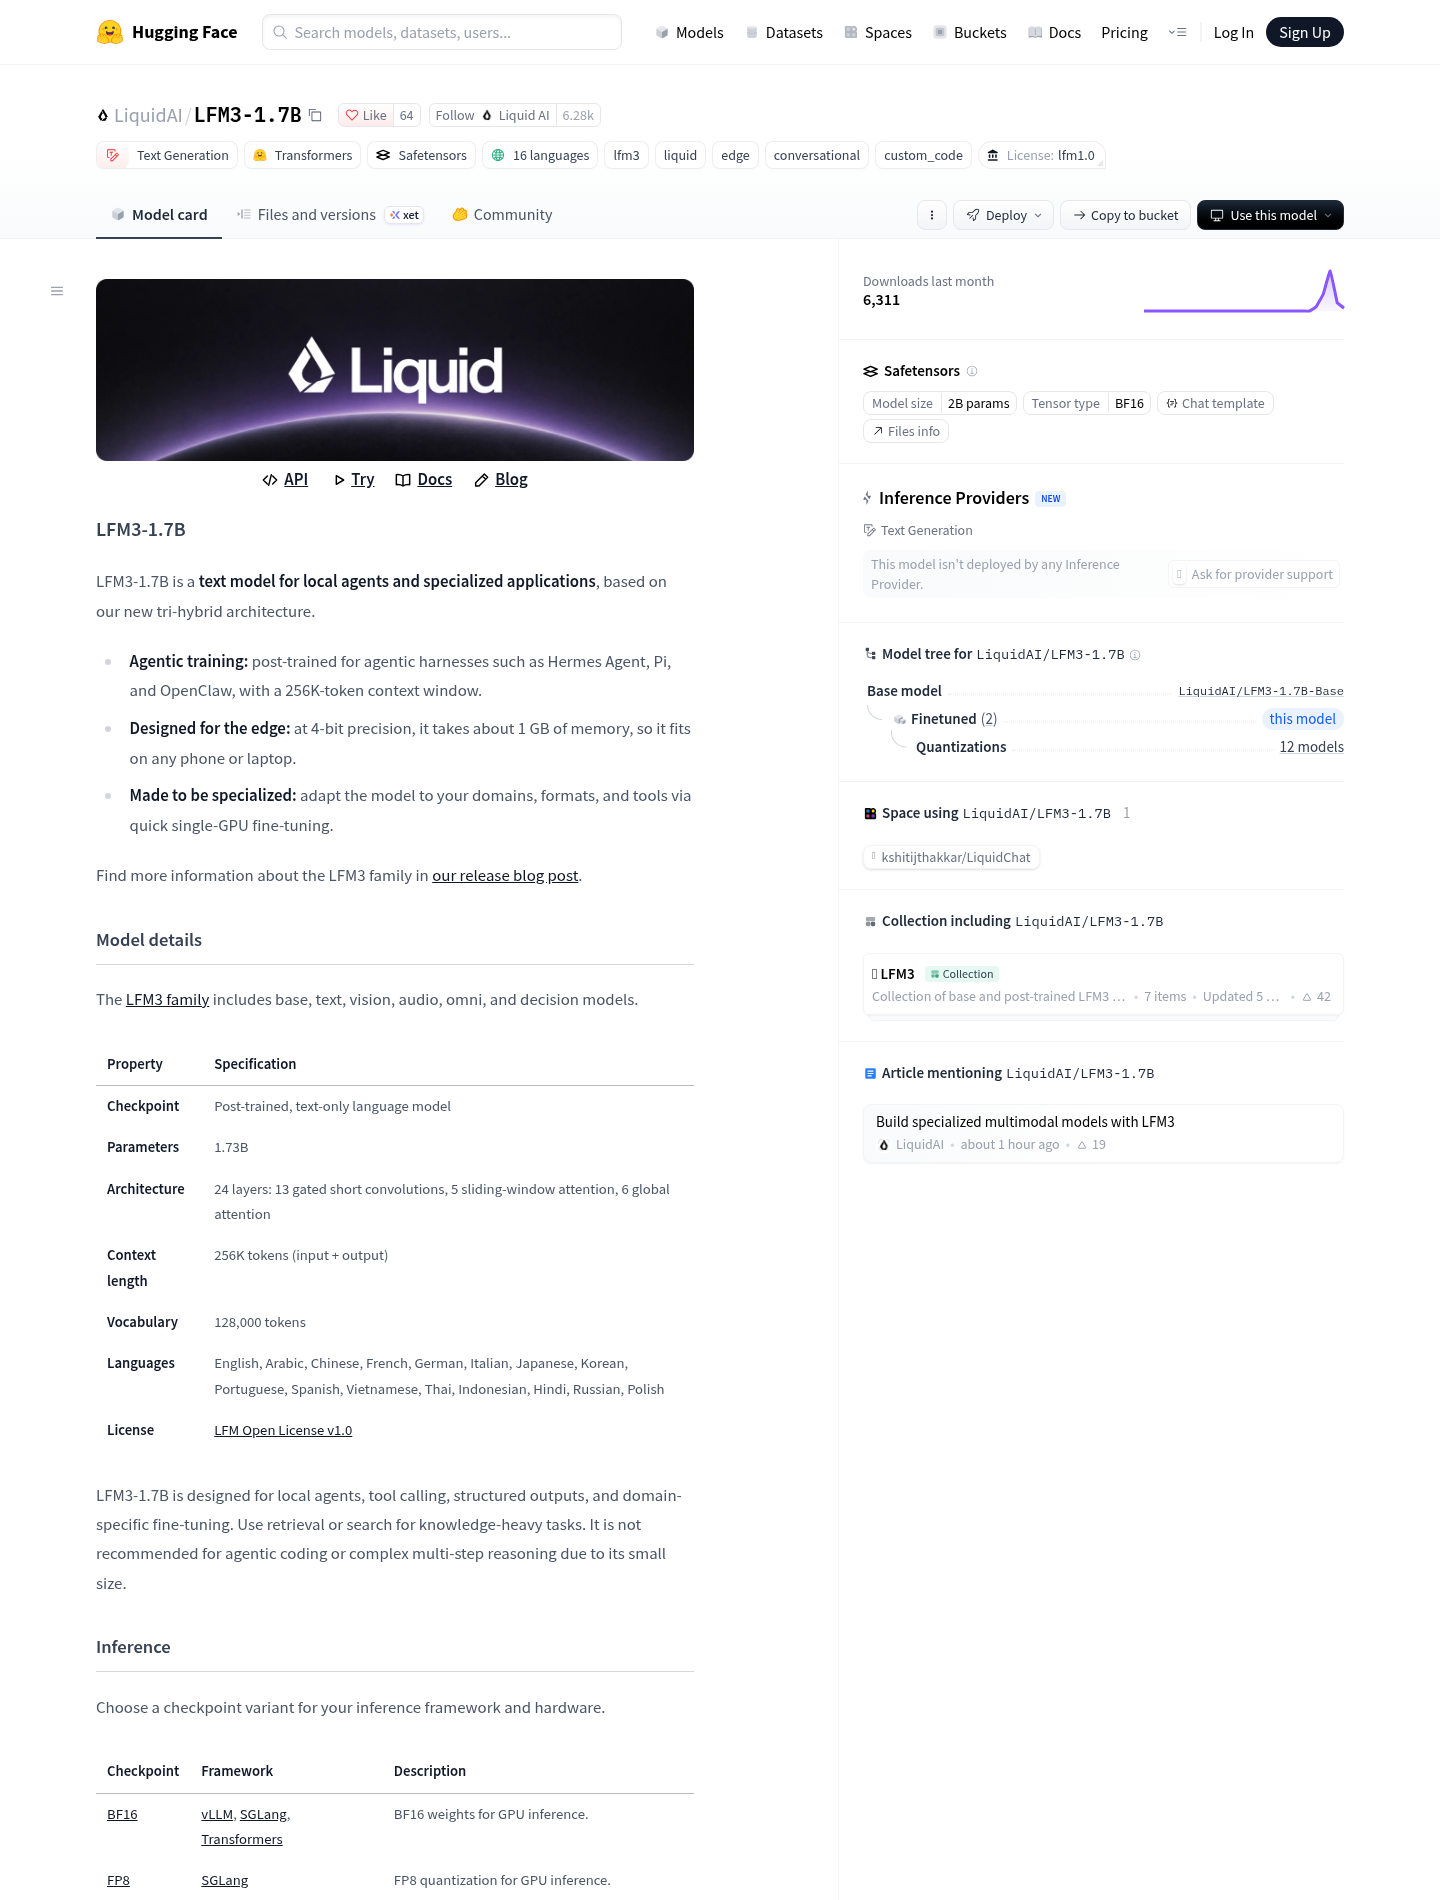
Đây là lựa chọn có lý: người dùng cần một mô hình gọn để chạy tại chỗ có thể ưu tiên văn bản, giọng nói hoặc thị giác, thay vì mang theo năng lực không cần thiết. Mô hình văn bản có 1,73 tỷ tham số; công ty cho biết bản này cần khoảng 1 GB bộ nhớ ở độ chính xác 4 bit. Các trọng số mở được cung cấp trên Hugging Face, Liquid AI Playground và API của công ty, mở đường cho thử nghiệm và tinh chỉnh thay vì chỉ sử dụng một dịch vụ đóng.
Cách tiếp cận này cũng phản ánh mục tiêu triển khai rộng: thiết kế được tối ưu qua quá trình đánh giá phần cứng, với 14 tổ hợp thiết bị và phần phụ trợ, từ điện thoại, Raspberry Pi 5, máy tính xách tay đến CPU, GPU và NPU. Tuy vậy, gọn nhẹ không đồng nghĩa với năng lực ngang các mô hình lớn.
Một backbone, ba kiểu xử lý
Cả sáu biến thể đều phát triển từ LFM3-1.7B-Base. Mô hình văn bản nhận và tạo văn bản; bản VL tiếp nhận văn bản, hình ảnh và video rồi trả lời bằng văn bản; bản Audio xử lý văn bản hoặc âm thanh, với đầu ra là văn bản hoặc lời nói. LFM3-Omni kết hợp văn bản, hình ảnh, video và âm thanh, đồng thời có thể tạo văn bản lẫn lời nói. Hai biến thể d1 và d1-omni nhắm vào quyết định có cấu trúc, trả về câu trả lời đã hiệu chuẩn thay vì văn xuôi tự do.
Backbone có 24 lớp theo thiết kế tri-hybrid: 13 lớp tích chập ngắn có cổng để xử lý mẫu cục bộ với chi phí thấp, năm lớp chú ý cửa sổ trượt 256 token cho quan hệ ở khoảng cách trung bình, và sáu lớp chú ý toàn cục để kết nối thông tin xa. Cửa sổ trượt 256 token là đặc tính của một nhóm lớp, không phải toàn bộ giới hạn ngữ cảnh. Mô hình văn bản và mô hình nền tảng được công bố có ngữ cảnh 256K token.
Thiết kế chung giúp Liquid tái sử dụng nền tảng rồi chuyên biệt hóa đầu vào, đầu ra và huấn luyện hậu kỳ. Nhưng không nên mặc định mọi biến thể có cùng cửa sổ ngữ cảnh: tài liệu chính thức được nêu trong nguồn chỉ xác nhận 256K cho mô hình văn bản và mô hình cơ sở, không công bố con số tương ứng cho các nhánh thị giác, âm thanh, Omni hay d1. Đây là khoảng trống đáng kể với ứng dụng cần xử lý chuỗi đa phương thức dài.
Benchmark là tín hiệu ban đầu, chưa phải bằng chứng
Các con số benchmark cần được đọc đúng mức: toàn bộ kết quả được trích dẫn do Liquid tự đo trên bộ đánh giá của mình và chưa được tái lập độc lập. Vì vậy, chúng hữu ích để định hướng thử nghiệm, nhưng chưa đủ để kết luận LFM3 vượt đối thủ hay sẵn sàng cho triển khai tự chủ. Nguồn nêu Terminal-Bench 2.1 đạt 12,92 và SWE-bench Multilingual đạt 23,00; các mức này không chứng minh khả năng xây dựng tác nhân lập trình tự chủ.
Giới hạn ấy phù hợp với cảnh báo ở thẻ mô hình: bản nhỏ không được khuyến nghị cho lập trình bằng tác tử hoặc suy luận phức tạp nhiều bước. Lợi thế tiềm năng của LFM3 nằm ở hiệu quả triển khai và lựa chọn chuyên biệt, không phải lời hứa thay thế mô hình lớn trong mọi công việc. Cùng thiết kế tri-hybrid, Liquid báo cáo KV cache 128K token ở mức 1,6 GB, thấp hơn các mô hình đối chiếu trong phép đo của hãng; con số này vẫn cần kiểm chứng độc lập và so sánh trong điều kiện tương đương.
Việc tiếp theo nên là thử nghiệm bên ngoài với tác vụ thực tế, đặc biệt là gọi công cụ, xử lý đa phương thức và độ trễ trên thiết bị. Liquid cho biết mọi mô hình có thể được tinh chỉnh trên một GPU và đã công bố hướng dẫn cho tinh chỉnh có giám sát, DPO, GRPO cùng tiếp tục tiền huấn luyện. Khả năng tiếp cận này có giá trị, nhưng cộng đồng vẫn cần tái lập benchmark trước khi coi LFM3 là lựa chọn mặc định.
Kết luận: đáng chú ý nhờ thiết kế, chưa thể chốt nhờ điểm số
LFM3 đưa ra một luận điểm thuyết phục: mô hình 2B vẫn có thể phục vụ nhiều dạng đầu vào nếu dùng backbone chung, kiến trúc lai và các nhánh chuyên biệt. Trọng số mở, ngữ cảnh dài ở bản văn bản và mức bộ nhớ thấp theo công bố của hãng khiến dòng này đáng thử với nhà phát triển cần chạy mô hình gần thiết bị hoặc muốn tự tinh chỉnh.
Tuy nhiên, một nền tảng chung không xóa được khác biệt giữa các biến thể, cũng không biến kết quả tự báo cáo thành bằng chứng độc lập. Người dùng nên chọn mô hình theo tác vụ, xác minh giới hạn ngữ cảnh của đúng nhánh cần dùng và tự đo chất lượng, tốc độ lẫn bộ nhớ trên phần cứng mục tiêu. LFM3 là bước tiến đáng quan tâm của AI đa phương thức gọn nhẹ; giá trị lâu dài sẽ phụ thuộc vào kiểm chứng thực tế, không chỉ vào kiến trúc.