
Độ chính xác không phải yếu tố quyết định
Mô hình phiên âm là hệ thống chuyển lời nói trong âm thanh thành văn bản, đôi khi bổ sung thông tin như người nói và thời điểm từng từ xuất hiện. Trong cuộc so sánh này, điểm số gần nhau không đồng nghĩa sản phẩm có cùng giá trị: quy trình làm việc sau khi chép lời mới là nơi Nemotron Transcribe tạo khác biệt.
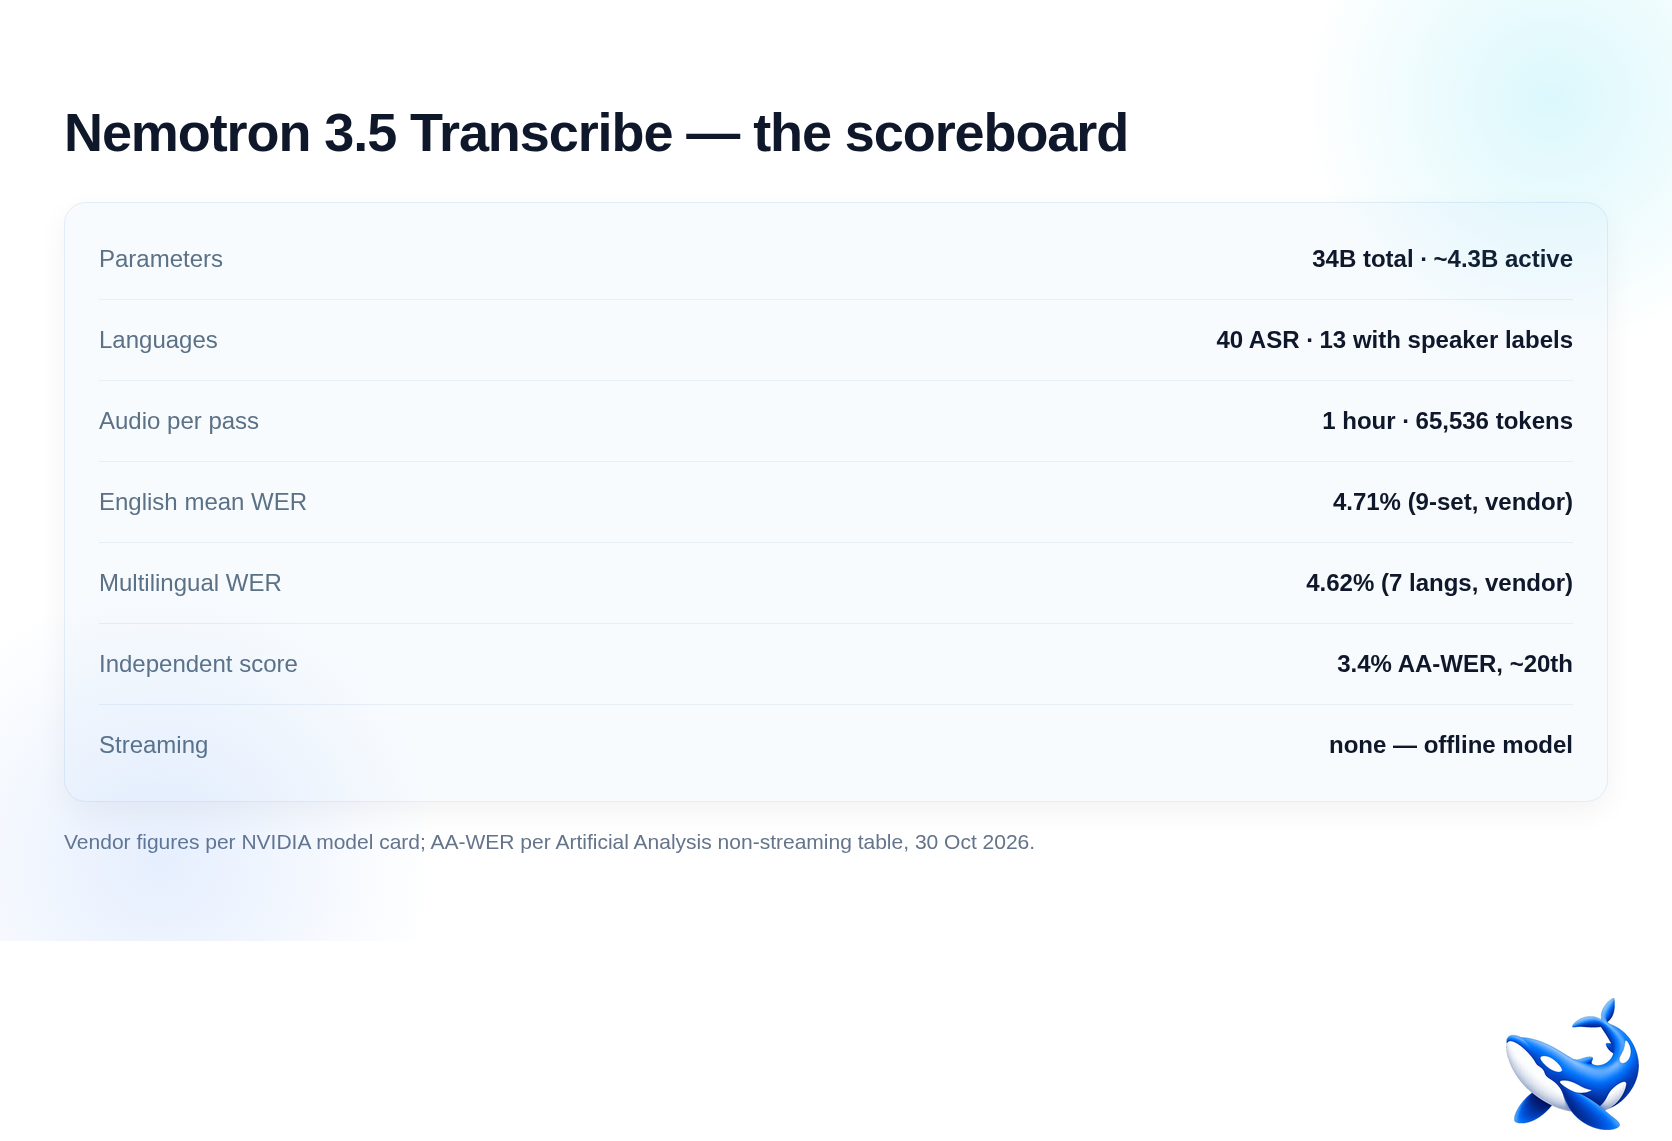
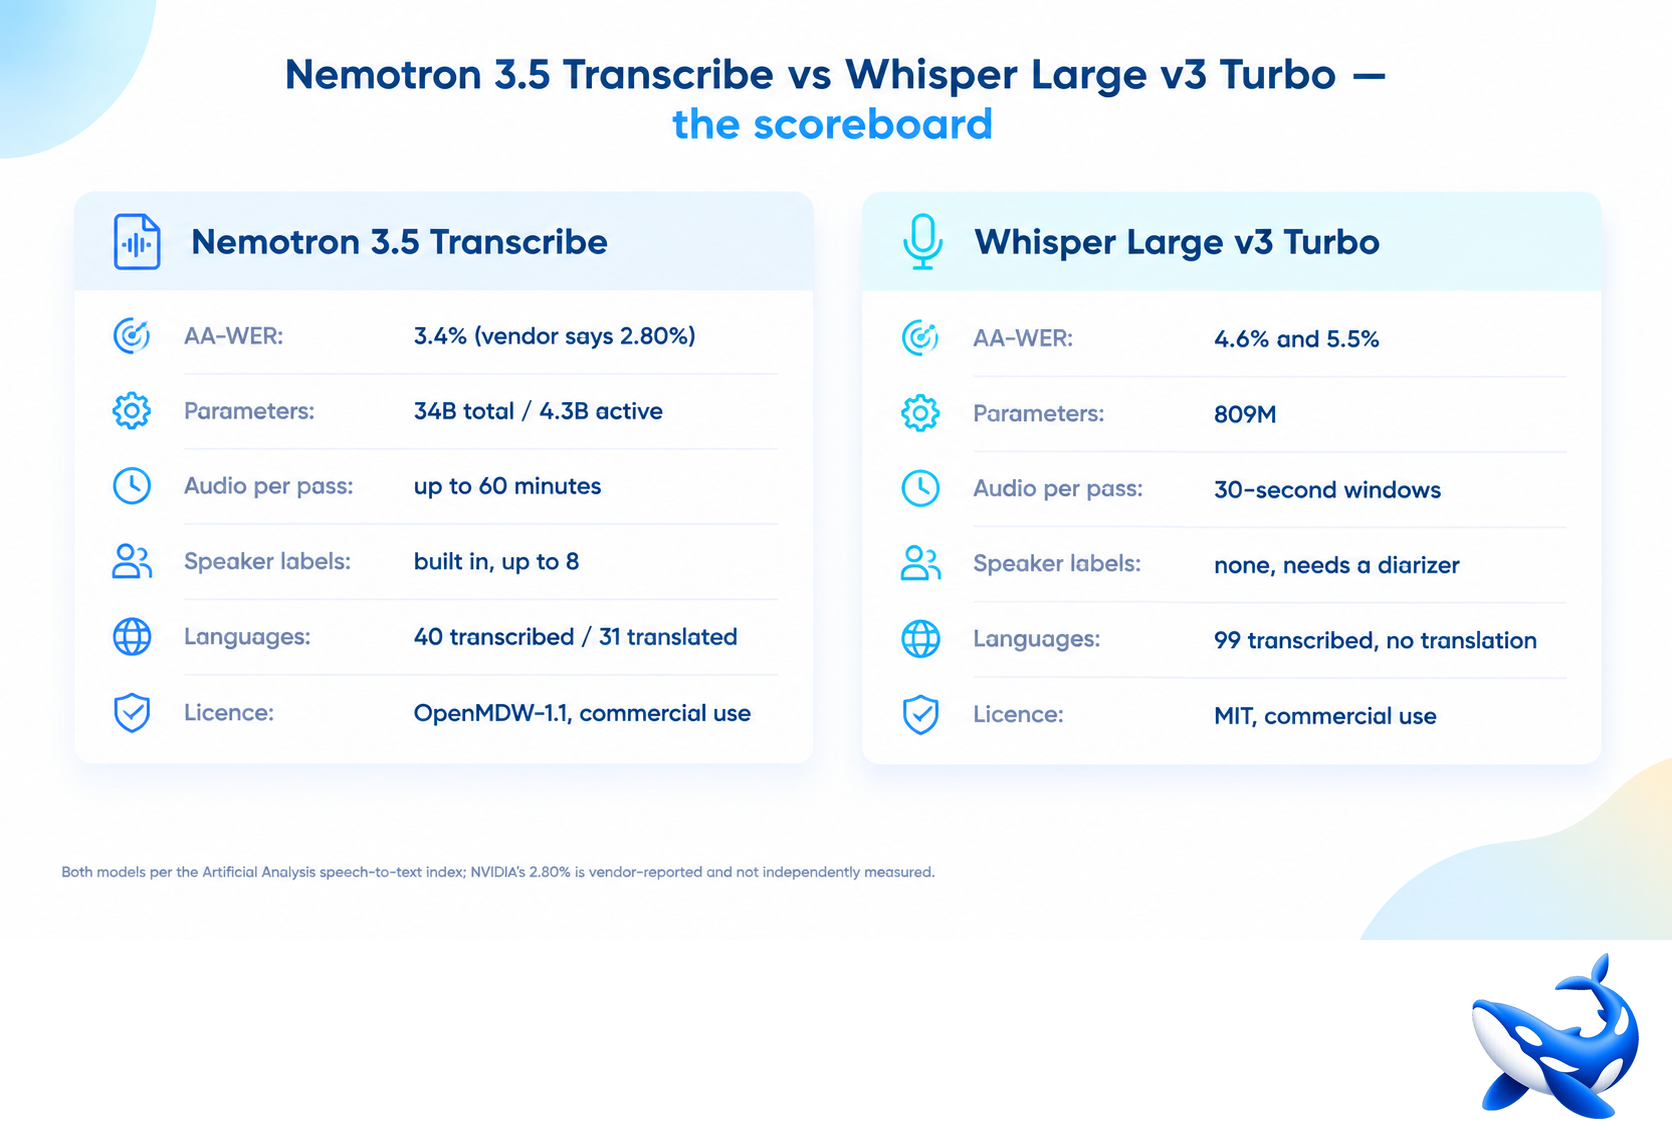
Trên chỉ số AA-WER không truyền phát, GPT Transcribe đạt 3,3%, còn Nemotron 3.5 Transcribe đạt 3,4%—chênh đúng 0,1 điểm phần trăm. Khoảng cách ấy nhỏ hơn mức dao động gần một điểm có thể xuất hiện giữa các endpoint của cùng một mô hình, nên không đủ làm căn cứ chọn bên thắng. Một lưu ý khác: bảng điểm hiện ghi Nemotron ở mức 3,4%, trong khi tài liệu ra mắt nêu 2,8%; chính sự bất nhất này nhắc rằng benchmark cần được đọc thận trọng. Các đánh giá độc lập cũng chưa chấm checkpoint mới này, vì vậy đừng xem một con số đơn lẻ là lời bảo đảm cho dữ liệu thực tế của bạn.
Nhãn người nói và thời gian từng từ: lợi thế thực dụng của Nemotron
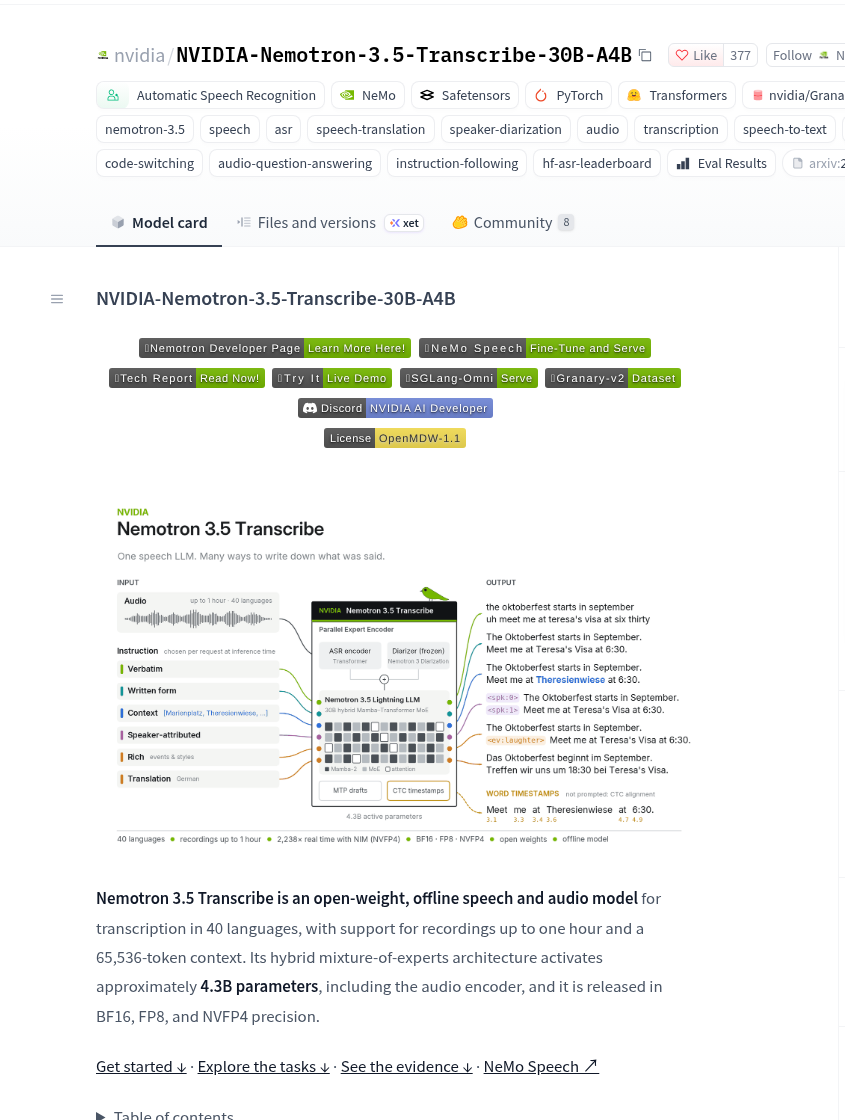
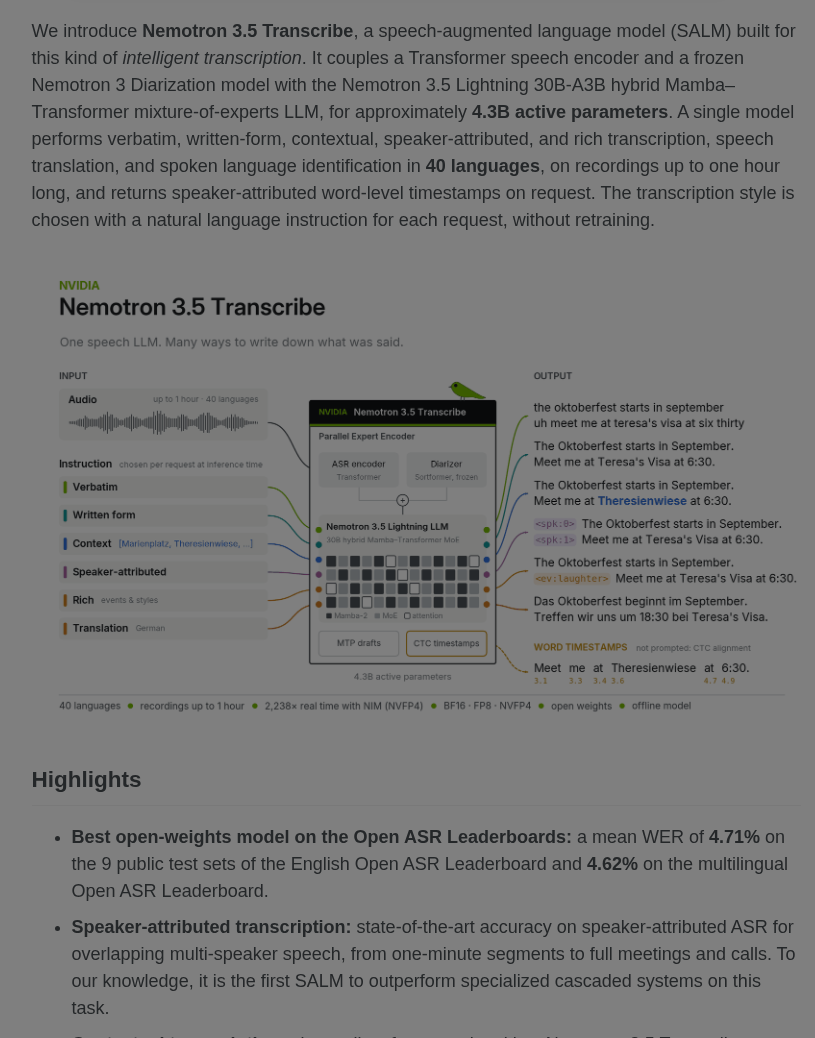
Khác biệt có ý nghĩa nhất nằm ở đầu ra. Nemotron có thể gắn nhãn tối đa tám người nói trong 13 ngôn ngữ và cung cấp mốc thời gian ở cấp từ ngay trong một lượt xử lý, nhờ bộ căn chỉnh CTC sau giải mã. Điều đó hữu ích cho phụ đề, tìm kiếm theo người nói, phân tích cuộc họp và lưu trữ cần truy vết.
GPT Transcribe không cung cấp nhãn người nói hay mốc thời gian từng từ trực tiếp trong đầu ra được mô tả; muốn có chúng, người dùng phải ghép thêm công cụ tách người nói hoặc dùng lựa chọn khác cho định thời gian. GPT bù lại bằng khả năng nhận ngữ cảnh tự do, từ khóa và gợi ý ngôn ngữ, đồng thời trả về ngôn ngữ được phát hiện. Nó cũng có nhiều cách tích hợp qua API, gồm phiên âm tệp, truyền phát và xử lý thời gian thực. Vì vậy, Nemotron thắng về độ giàu dữ liệu trong một lượt, còn GPT hấp dẫn hơn nếu ưu tiên một dịch vụ API linh hoạt và không muốn tự lắp ghép hạ tầng.
Whisper gọn nhẹ hơn, Nemotron giàu tính năng hơn
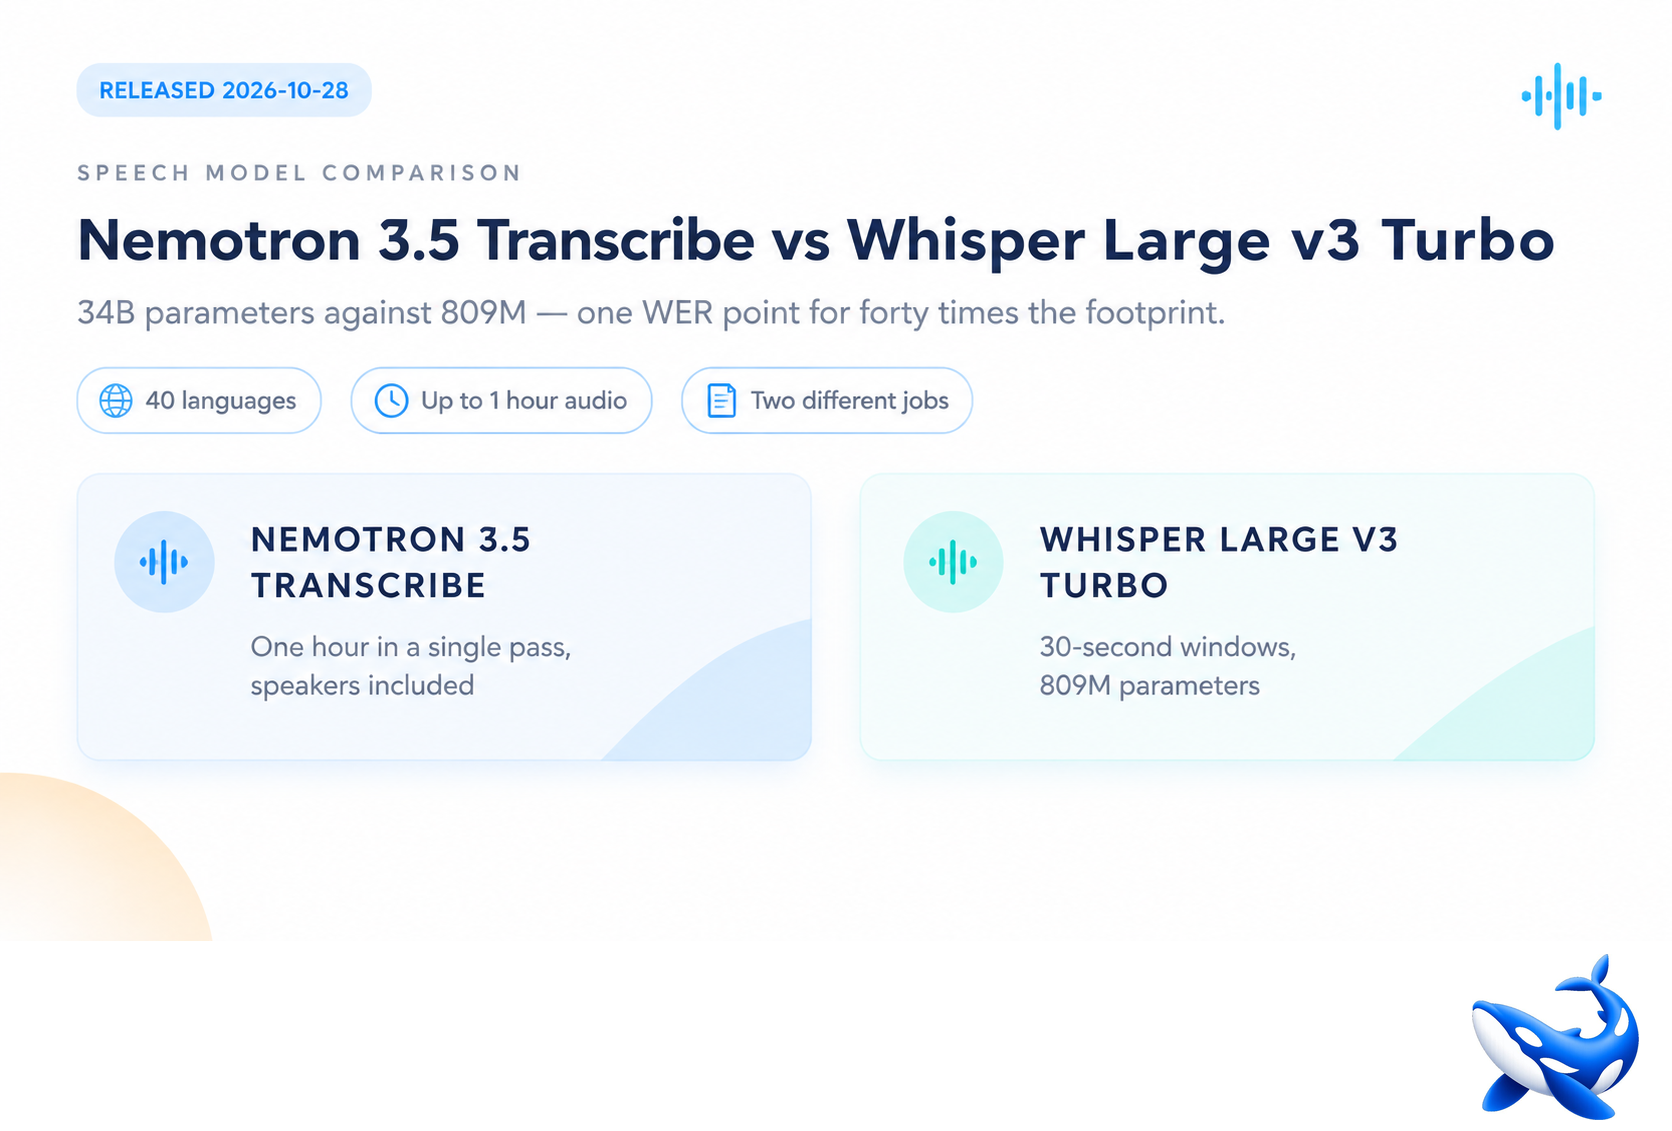
So với Whisper Large v3 Turbo, Nemotron nổi bật ở nhãn người nói tích hợp và định thời gian từng từ. Whisper không có token người nói trong từ vựng, nên cần thêm một mô hình tách người nói; định thời gian cấp từ cũng cần bước căn chỉnh riêng. Nhưng lợi thế tính năng của Nemotron phải trả bằng dấu chân tài nguyên lớn hơn: trọng số ở định dạng BF16 vào khoảng 68 GB, trong khi Whisper cần khoảng 1,6 GB ở FP16 hoặc 0,81 GB ở INT8.
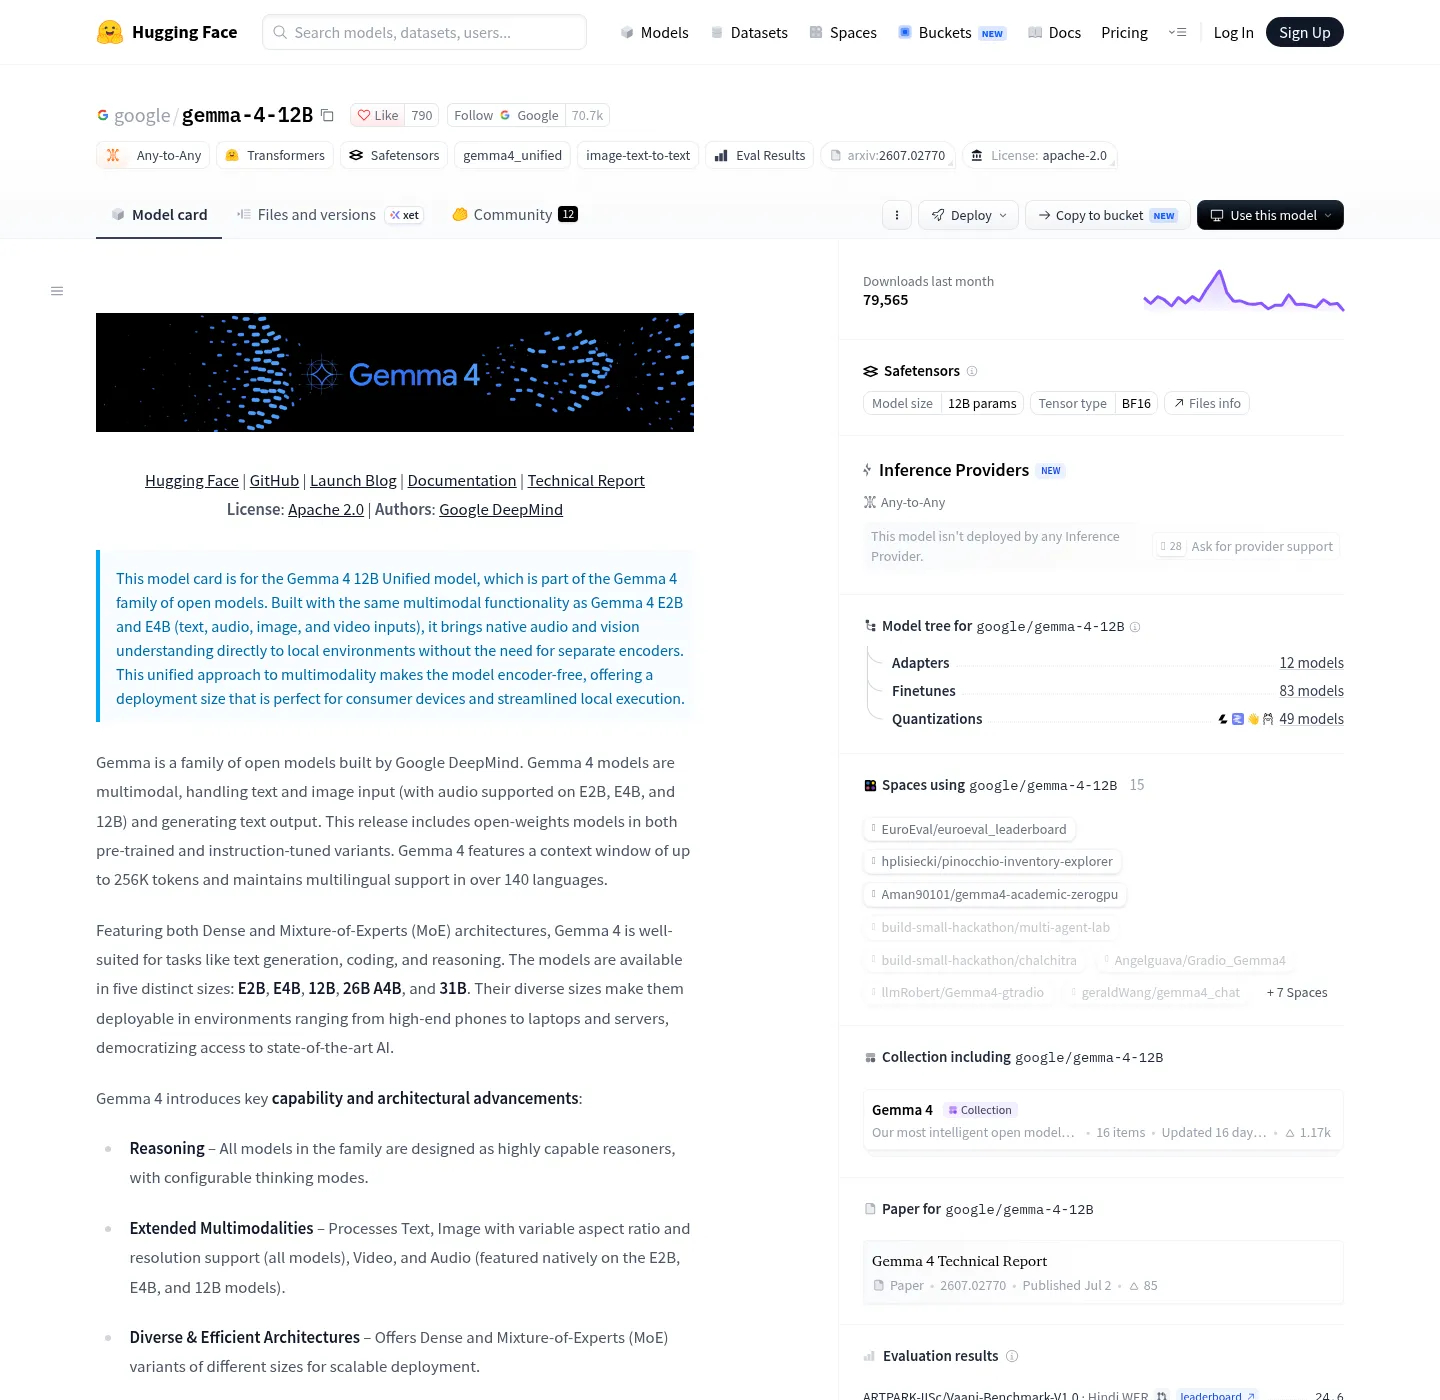
Whisper Turbo còn hỗ trợ 99 ngôn ngữ được phiên âm, so với 40 ngôn ngữ của Nemotron; riêng các ngôn ngữ như Kazakh, Tamil, Swahili và Wales có thể khiến lựa chọn nghiêng về Whisper. Ngược lại, Nemotron xử lý bản ghi dài đến một giờ trong một lượt, trong khi Whisper chia âm thanh dài thành các đoạn. Vì thế, gọi Nemotron là bản nâng cấp tuyệt đối sẽ sai: đây là lựa chọn giàu đầu ra hơn nhưng nặng hơn, còn Whisper phù hợp khi dung lượng, khả năng chạy trên CPU và độ phủ ngôn ngữ quan trọng hơn.
| Tiêu chí | Nemotron 3.5 Transcribe | Whisper Large v3 Turbo |
|---|---|---|
| Nhãn người nói | Tích hợp, tối đa 8 người nói trong 13 ngôn ngữ | Không tích hợp; cần mô hình tách người nói riêng |
| Mốc thời gian từng từ | Có, qua căn chỉnh CTC | Cần bước căn chỉnh riêng |
| Dung lượng trọng số | Khoảng 68 GB ở BF16 | Khoảng 1,6 GB ở FP16; 0,81 GB ở INT8 |
| Ngôn ngữ phiên âm | 40 | 99 |
Giấy phép, chi phí và lựa chọn theo công việc
Nemotron phát hành dưới giấy phép OpenMDW-1.1, cho phép sử dụng thương mại và tải trọng số; GPT Transcribe chỉ dùng qua API. Với GPT, người dùng mua sự tiện lợi và tránh cấp phát GPU. Với Nemotron, không có giá tính theo phút được niêm yết trong tài liệu; đổi lại, bạn phải tự lo năng lực GPU và vận hành. Do đó, chi phí thực tế phụ thuộc vào hạ tầng sẵn có và lượng âm thanh, chứ không thể kết luận chỉ từ độ chính xác.
- Mua nếu cần bản chép lời nhanh, không muốn tự quản lý máy chủ và ưu tiên một API tích hợp sẵn.
- Bỏ qua nếu quy trình cần nhãn người nói và mốc thời gian từng từ ngay trong một lượt; khi đó, Nemotron có thể giảm phần tích hợp bổ sung.
- Mua nếu có GPU phù hợp, muốn tải trọng số để triển khai theo nhu cầu hoặc cần xử lý bản ghi dài một lần.
- Bỏ qua Nemotron nếu phần cứng hạn chế hoặc hàng đợi cần những ngôn ngữ Whisper hỗ trợ mà Nemotron không tuyên bố hỗ trợ.
- Cân nhắc Whisper Large v3 Turbo khi dung lượng nhỏ, khả năng chạy trên CPU và độ phủ ngôn ngữ là ưu tiên cao hơn dữ liệu người nói tích hợp.
Kết luận: GPT Transcribe là lựa chọn ít rủi ro cho nhu cầu chép lời đơn giản; Nemotron 3.5 Transcribe đáng chuyển sang khi nhãn người nói và thời gian từng từ giúp giảm công đoạn phía sau; Whisper Large v3 Turbo vẫn có chỗ đứng nhờ gọn nhẹ và hỗ trợ nhiều ngôn ngữ. Trong một phép so sánh mô hình phiên âm, hãy chọn theo đầu ra và hạ tầng cần dùng, không theo chênh lệch WER chỉ một phần mười điểm.