
Nền tảng AI tự lưu trữ gồm những gì?
Nền tảng AI tự lưu trữ là hệ thống chạy mô hình và dịch vụ AI trên phần cứng do bạn quản lý, rồi cung cấp một điểm truy cập chung để ứng dụng gửi yêu cầu đến đúng nơi xử lý. Cách làm này phù hợp nếu bạn đã có GPU chạy AI và muốn kiểm soát dữ liệu, mô hình cùng cách sử dụng chúng. Điều kiện thực tế là GPU phải còn đủ bộ nhớ cho mô hình và độ dài ngữ cảnh dự kiến; 16 GB VRAM là mốc khởi đầu hợp lý cho ví dụ hai mô hình, nhưng mức dùng thay đổi theo phần cứng, trình điều khiển, bản vLLM và ngữ cảnh yêu cầu.
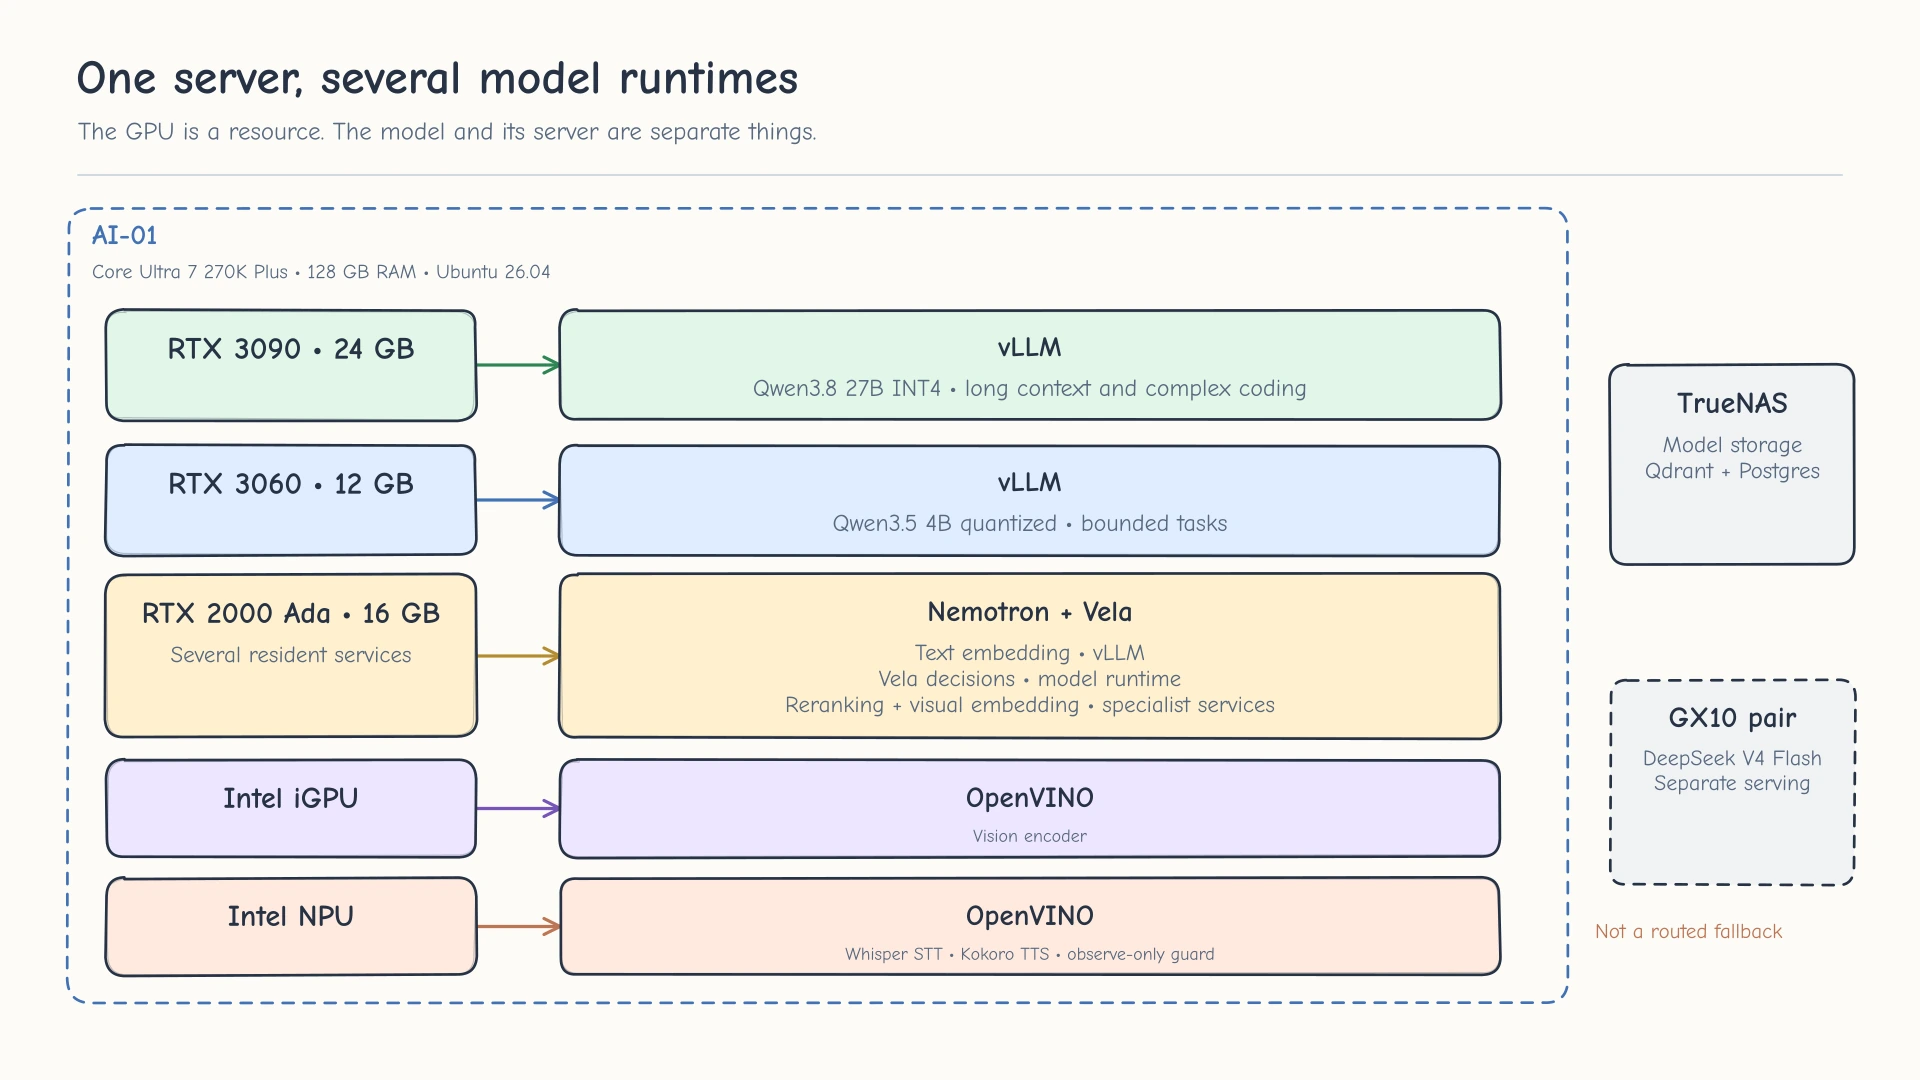
Bạn không cần tìm một mô hình AI cục bộ làm tốt mọi việc. Trên máy có RTX 4070 Ti Super 16 GB và Ryzen 5 7600X, người dùng nguồn thử nghiệm luân phiên ba mô hình chuyên cho các tác vụ phù hợp, gồm nghiên cứu, viết mã và tạo hoặc chỉnh sửa ảnh. vLLM là gì? Đây là máy chủ phục vụ mô hình: nó chạy mô hình và truyền phản hồi về qua bộ định tuyến. Bản thân vLLM không giải quyết hết chuyện quản lý nhiều GPU, máy AI hay dịch vụ như xử lý tiếng nói và truy xuất tài liệu. Nền tảng càng mở rộng thì càng có nhiều dịch vụ cần cấu hình, giám sát và kiểm thử.
Chuẩn bị phần cứng và dựng bản thử nghiệm
Hãy bắt đầu bằng một máy Linux và hai mô hình Qwen chạy qua vLLM, thay vì dựng ngay một homelab nhiều máy. Bạn cần trình điều khiển NVIDIA, Docker Engine với Compose v2 và NVIDIA Container Toolkit; GPU cũng phải có đủ VRAM trống cho các mô hình. Thực hiện lần lượt các bước sau:
- Cài đặt và kiểm tra trình điều khiển NVIDIA trên máy chủ. Xác nhận hệ điều hành nhận GPU trước khi cấu hình các dịch vụ AI.
- Cài Docker Engine, Compose v2 và NVIDIA Container Toolkit. Chạy một phép thử trong container để kiểm tra Docker có nhìn thấy GPU hay không.
- Nếu container không thấy GPU, sửa cấu hình runtime NVIDIA của Docker trước khi tiếp tục; bộ định tuyến không thể khắc phục máy chủ mô hình không truy cập được phần cứng.
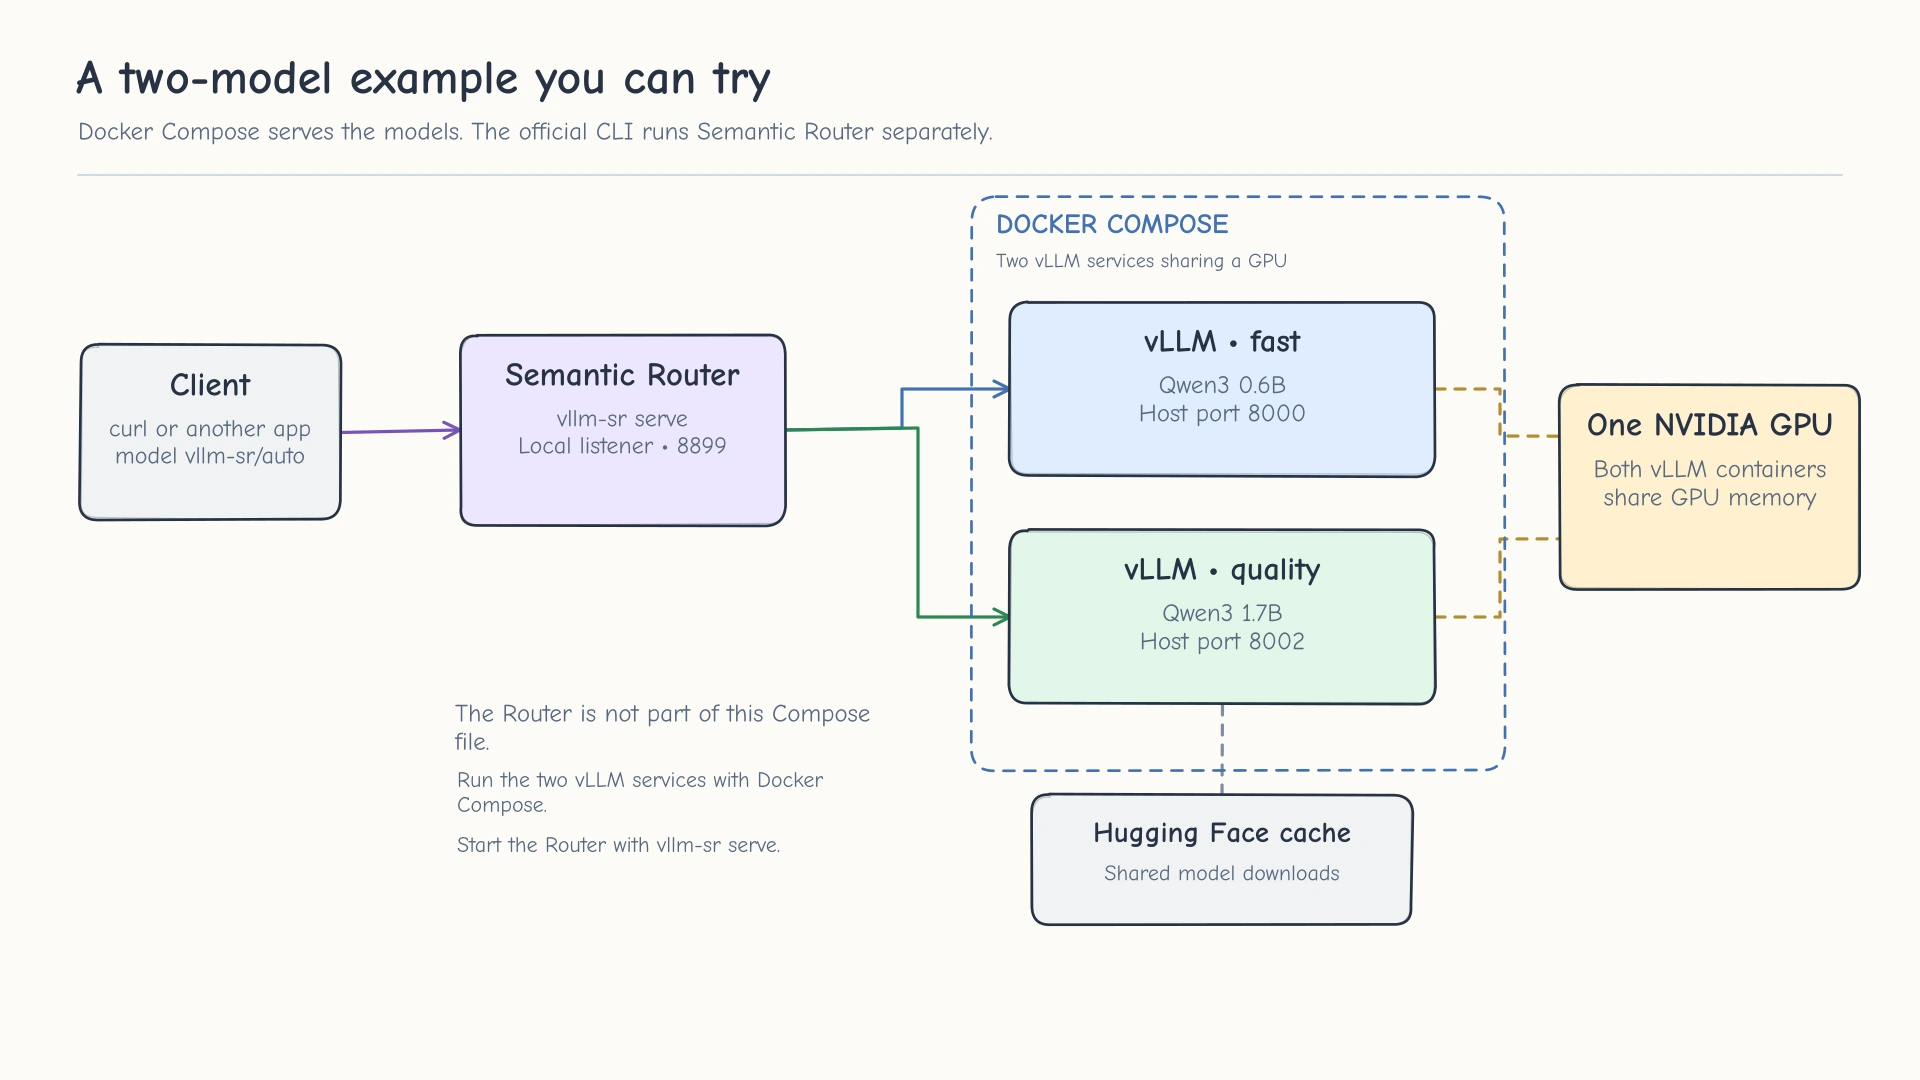
- Tạo cấu hình Compose cho hai máy chủ vLLM, mỗi máy chủ chạy một mô hình Qwen cục bộ. Kiểm tra riêng từng mô hình và giới hạn ngữ cảnh phù hợp với VRAM.
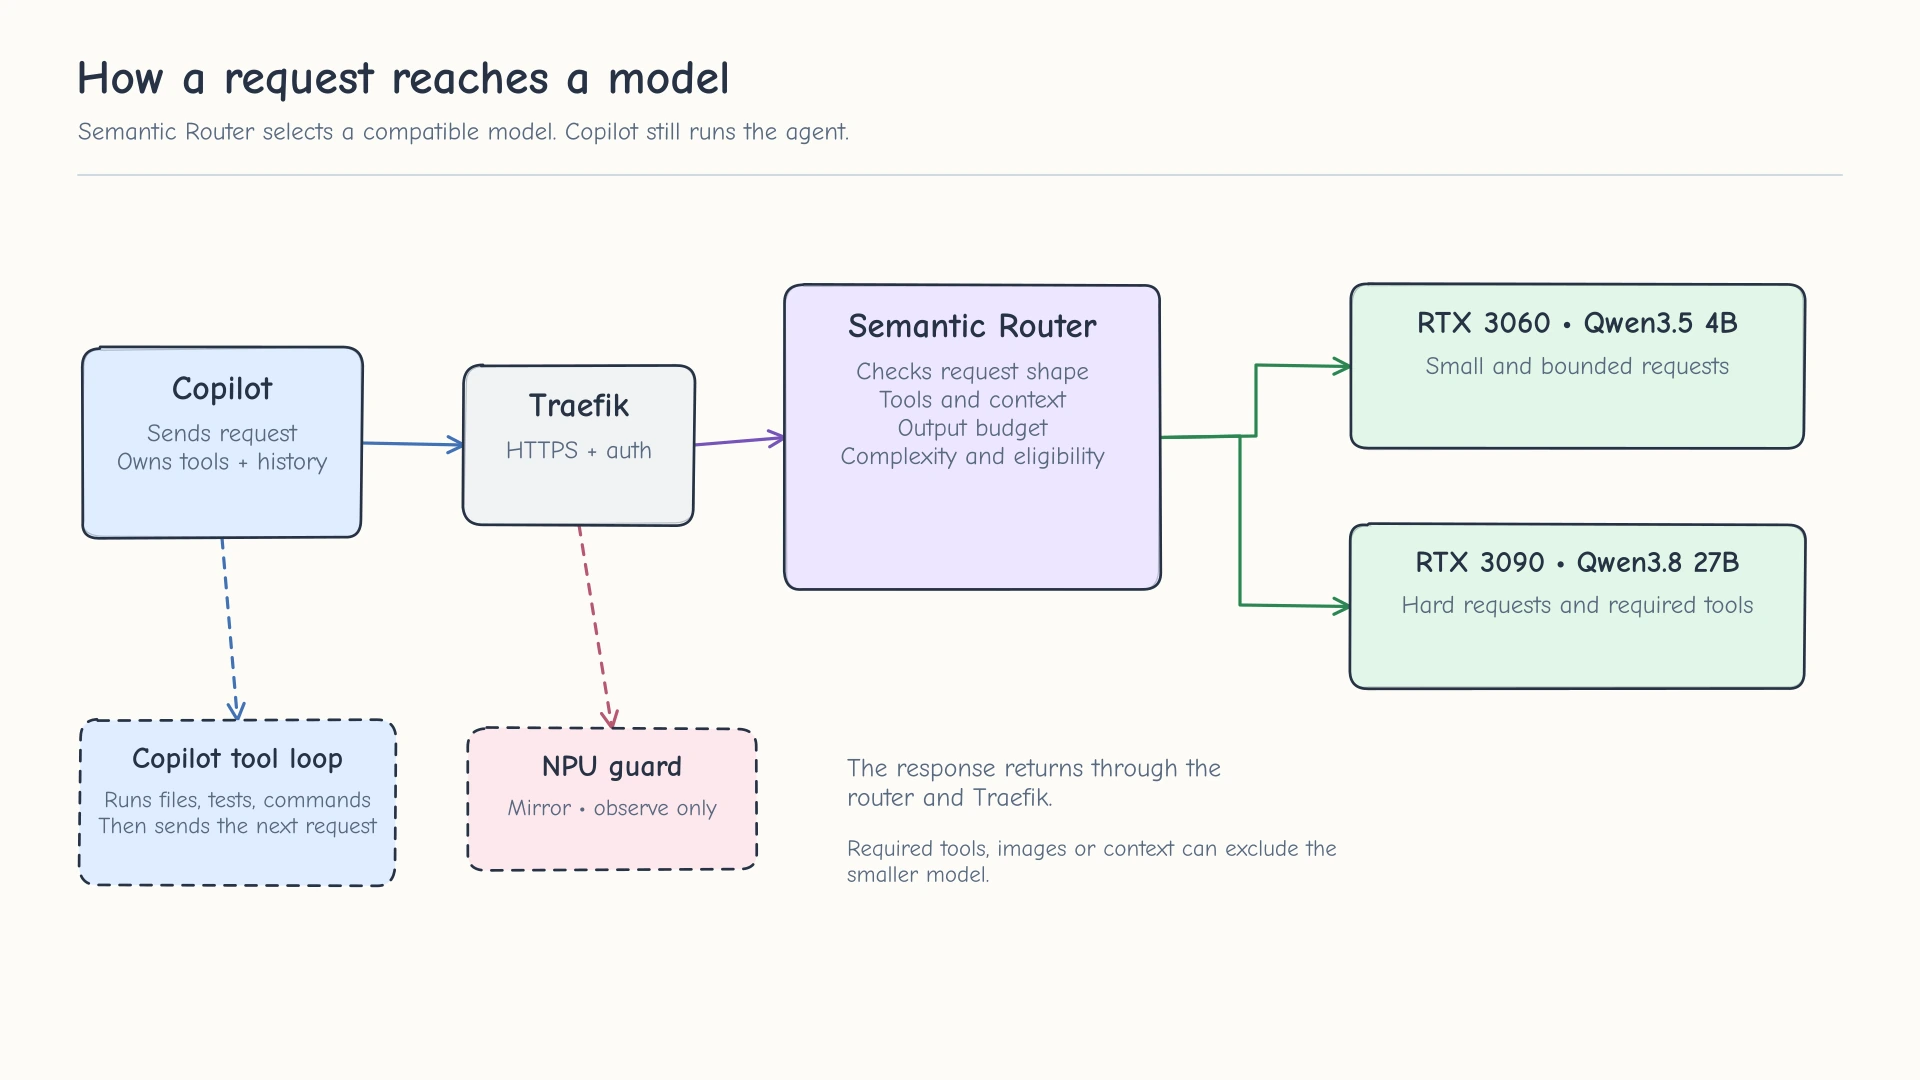
- Cấu hình Semantic Router nhận yêu cầu ở một điểm vào và chọn giữa hai backend theo chính sách cùng khả năng của mô hình. Sau đó thử từ một ứng dụng OpenAI-compatible qua điểm vào này.
Bản thử nghiệm trên giúp bạn xác minh đường đi từ ứng dụng đến mô hình trước khi thêm phần cứng hoặc dịch vụ khác. Đừng đưa các cổng vLLM ra Internet: cấu hình Compose mẫu công bố hai cổng không có xác thực để bộ định tuyến truy cập, nên hãy giới hạn chúng bằng tường lửa và không chuyển tiếp cổng qua bộ định tuyến gia đình.
Định tuyến đúng việc, tránh lỗi khó thấy
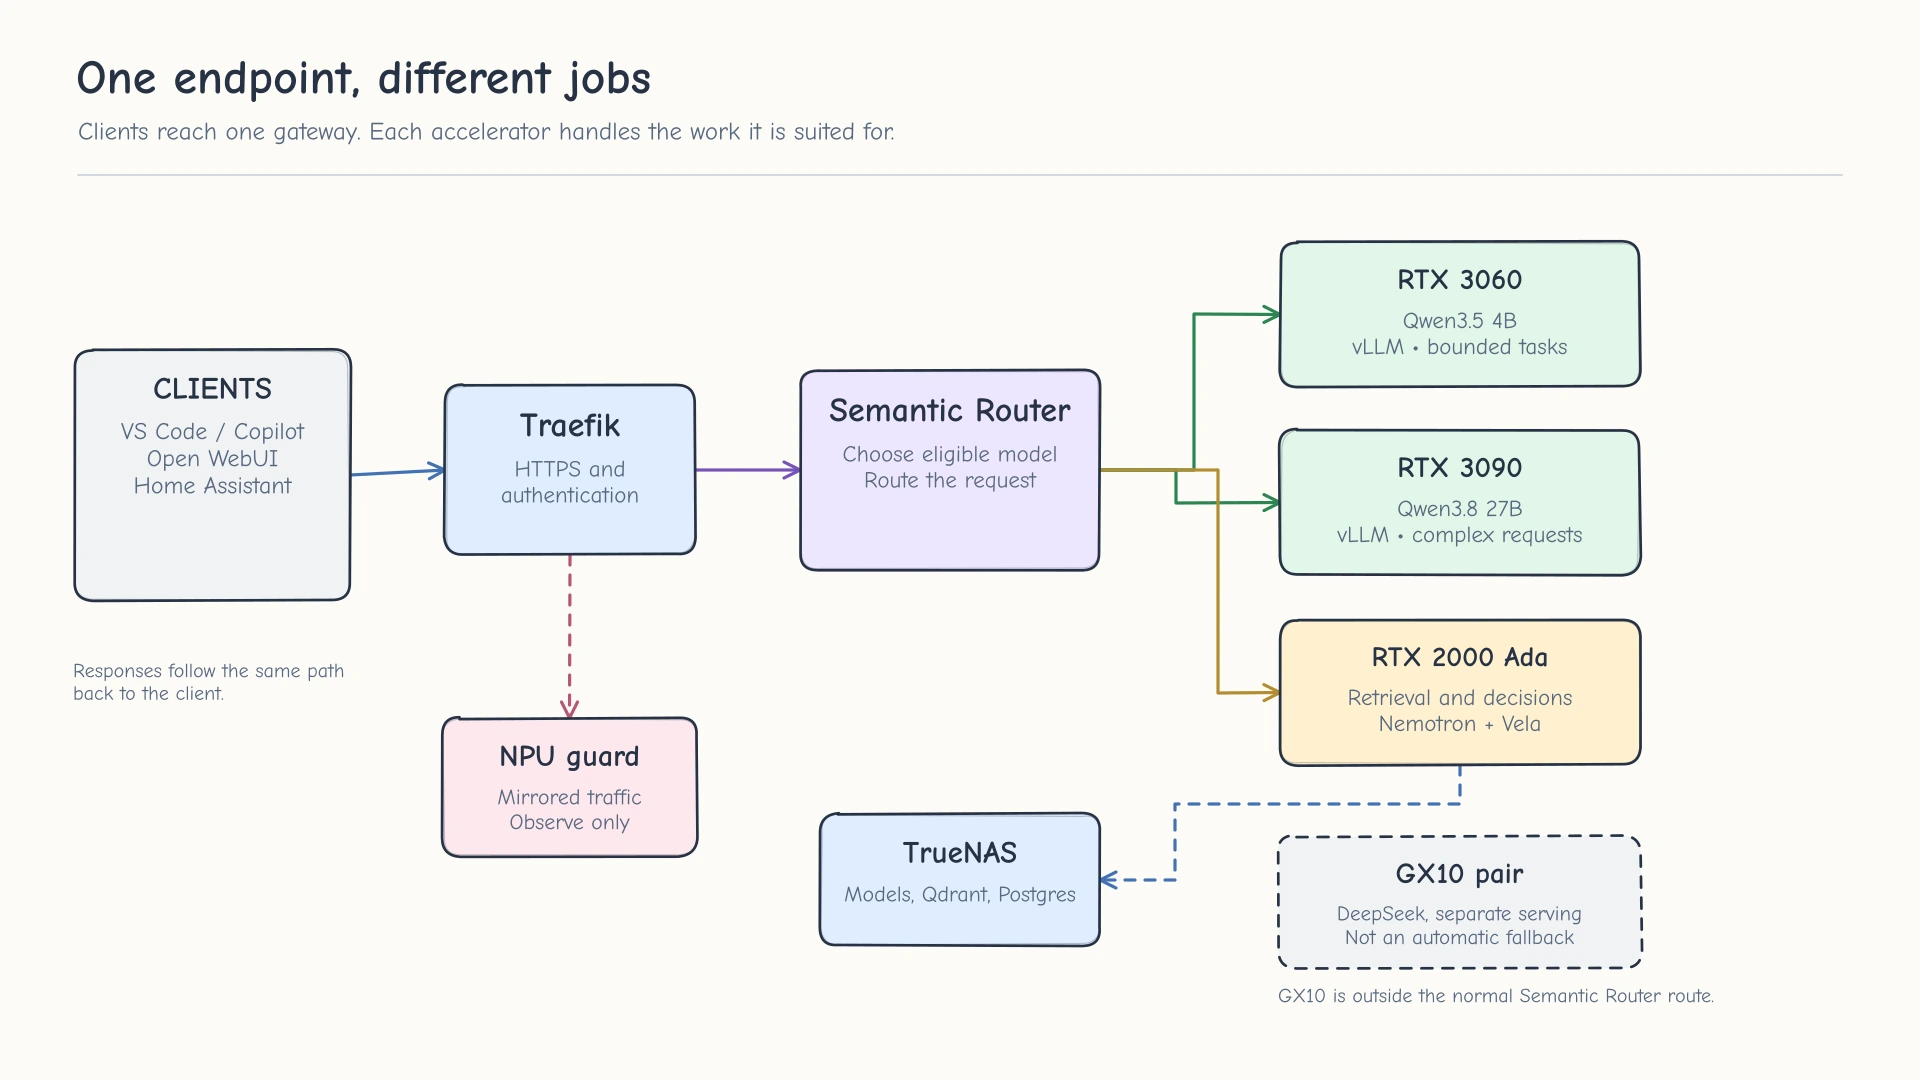
Trong hệ thống nhiều mô hình, Semantic Router xem yêu cầu và khả năng của các backend để chọn nơi xử lý; các dịch vụ còn lại tiếp tục làm nhiệm vụ riêng. Chẳng hạn, một yêu cầu ngắn có thể dùng mô hình nhỏ, còn việc cần suy luận khó hoặc ngữ cảnh dài có thể chuyển đến mô hình lớn hơn. Ứng dụng chỉ gọi một điểm vào, không cần biết yêu cầu được xử lý trên GPU nào; phản hồi quay lại qua cùng kết nối.
Điểm dễ vấp là chỉ định tuyến theo vài từ trong prompt. Một yêu cầu trông ngắn vẫn có thể mang theo lịch sử hội thoại dài hoặc danh sách công cụ lớn; mô hình được chọn có thể không nhận nổi định dạng đó. Vì vậy, hãy kiểm tra giới hạn ngữ cảnh, ngân sách đầu ra, khả năng dùng công cụ và hình dạng yêu cầu thực tế. Router cũng không thay thế vòng lặp tác vụ, lời gọi công cụ hay lịch sử hội thoại của ứng dụng. Khi mọi thứ ổn định, bạn có thể bổ sung máy khác, GPU khác hoặc dịch vụ nhúng và tiếng nói, nhưng phải kiểm thử từng tuyến riêng.