
Trọng số mở không đồng nghĩa với dễ triển khai
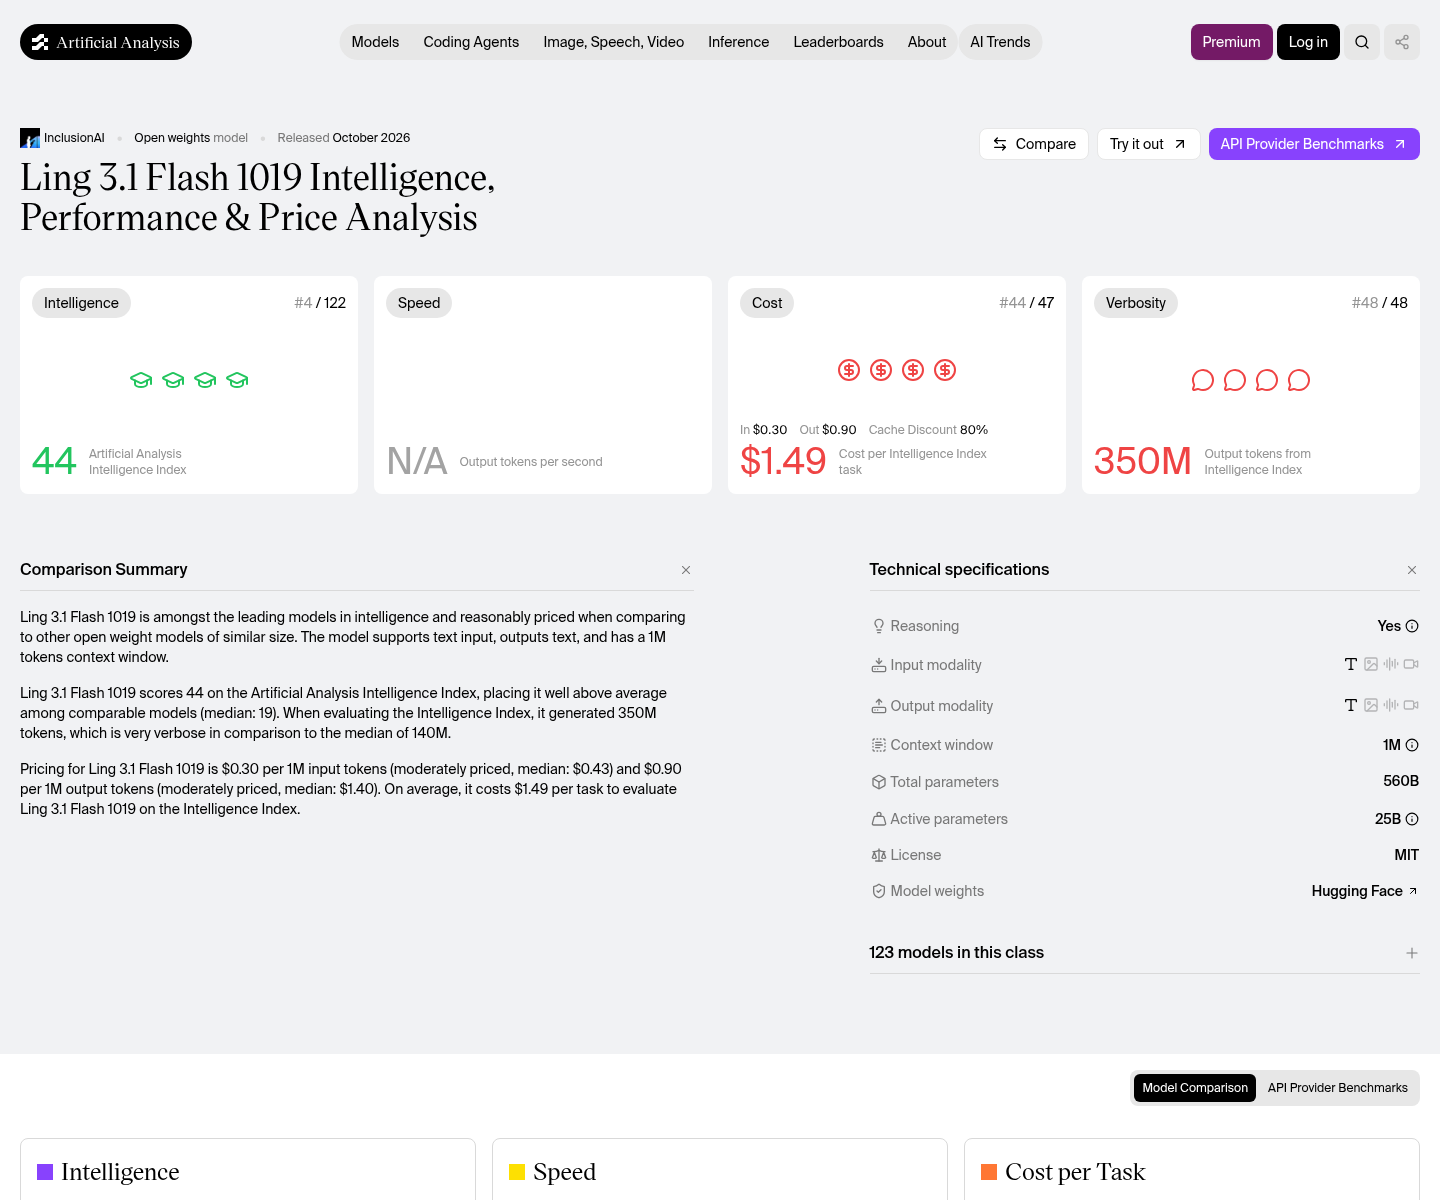
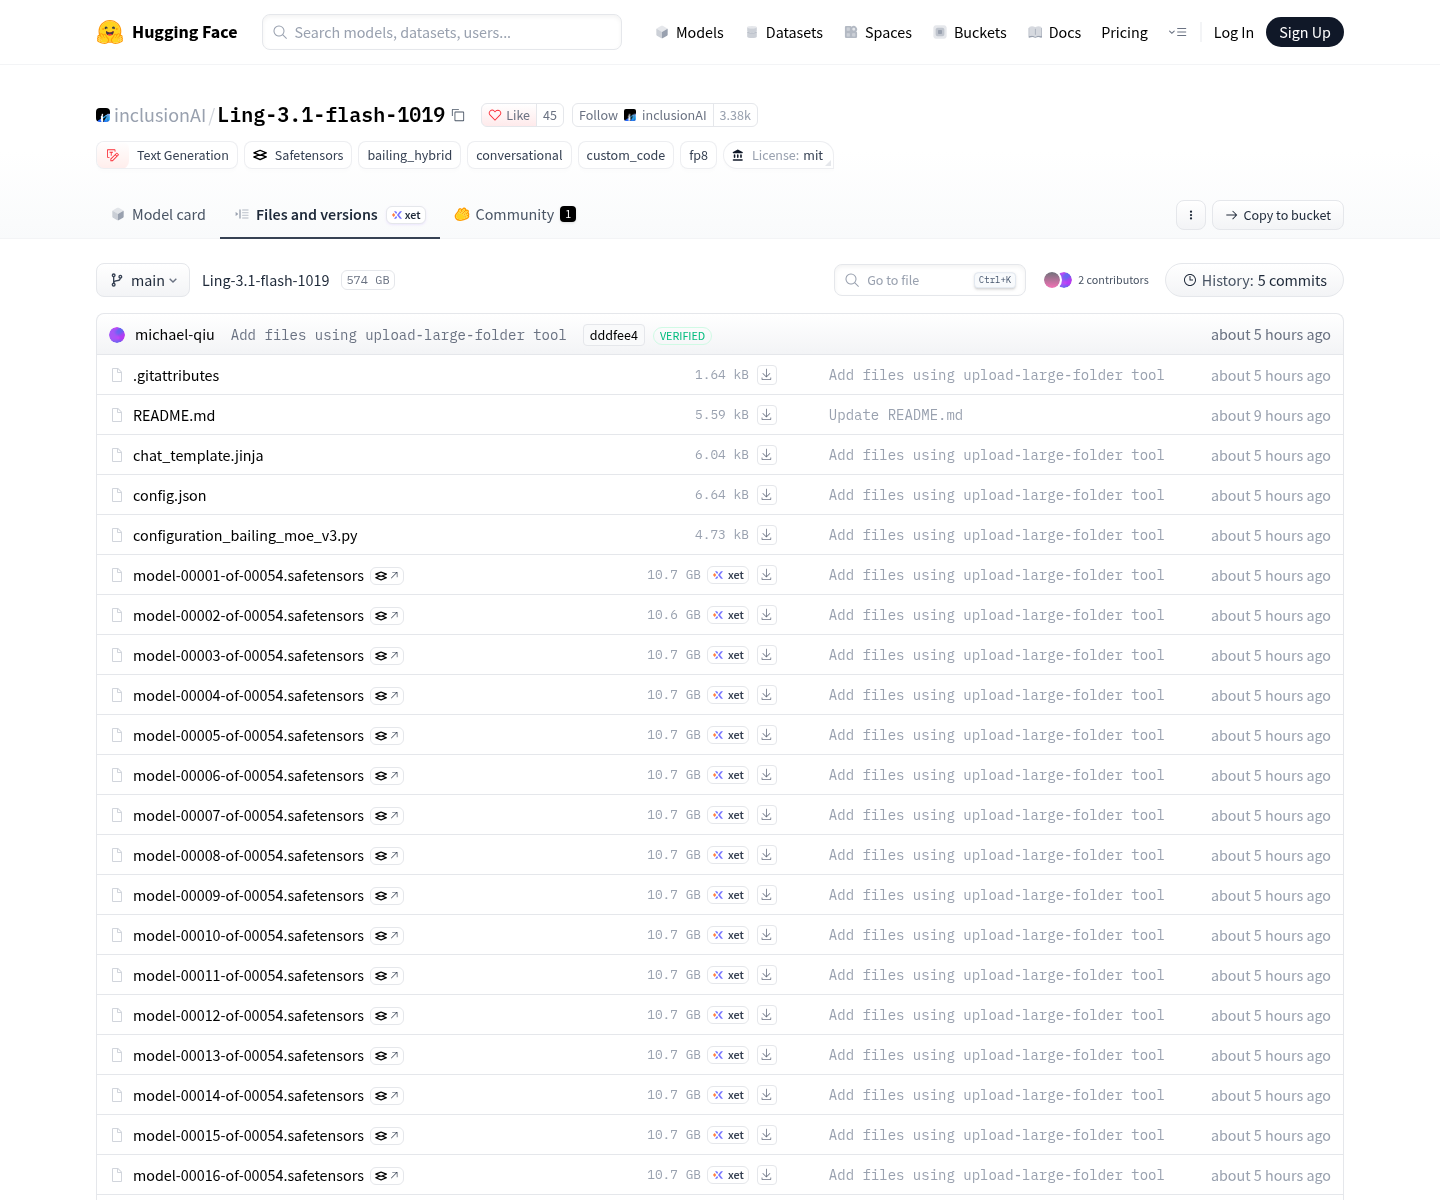
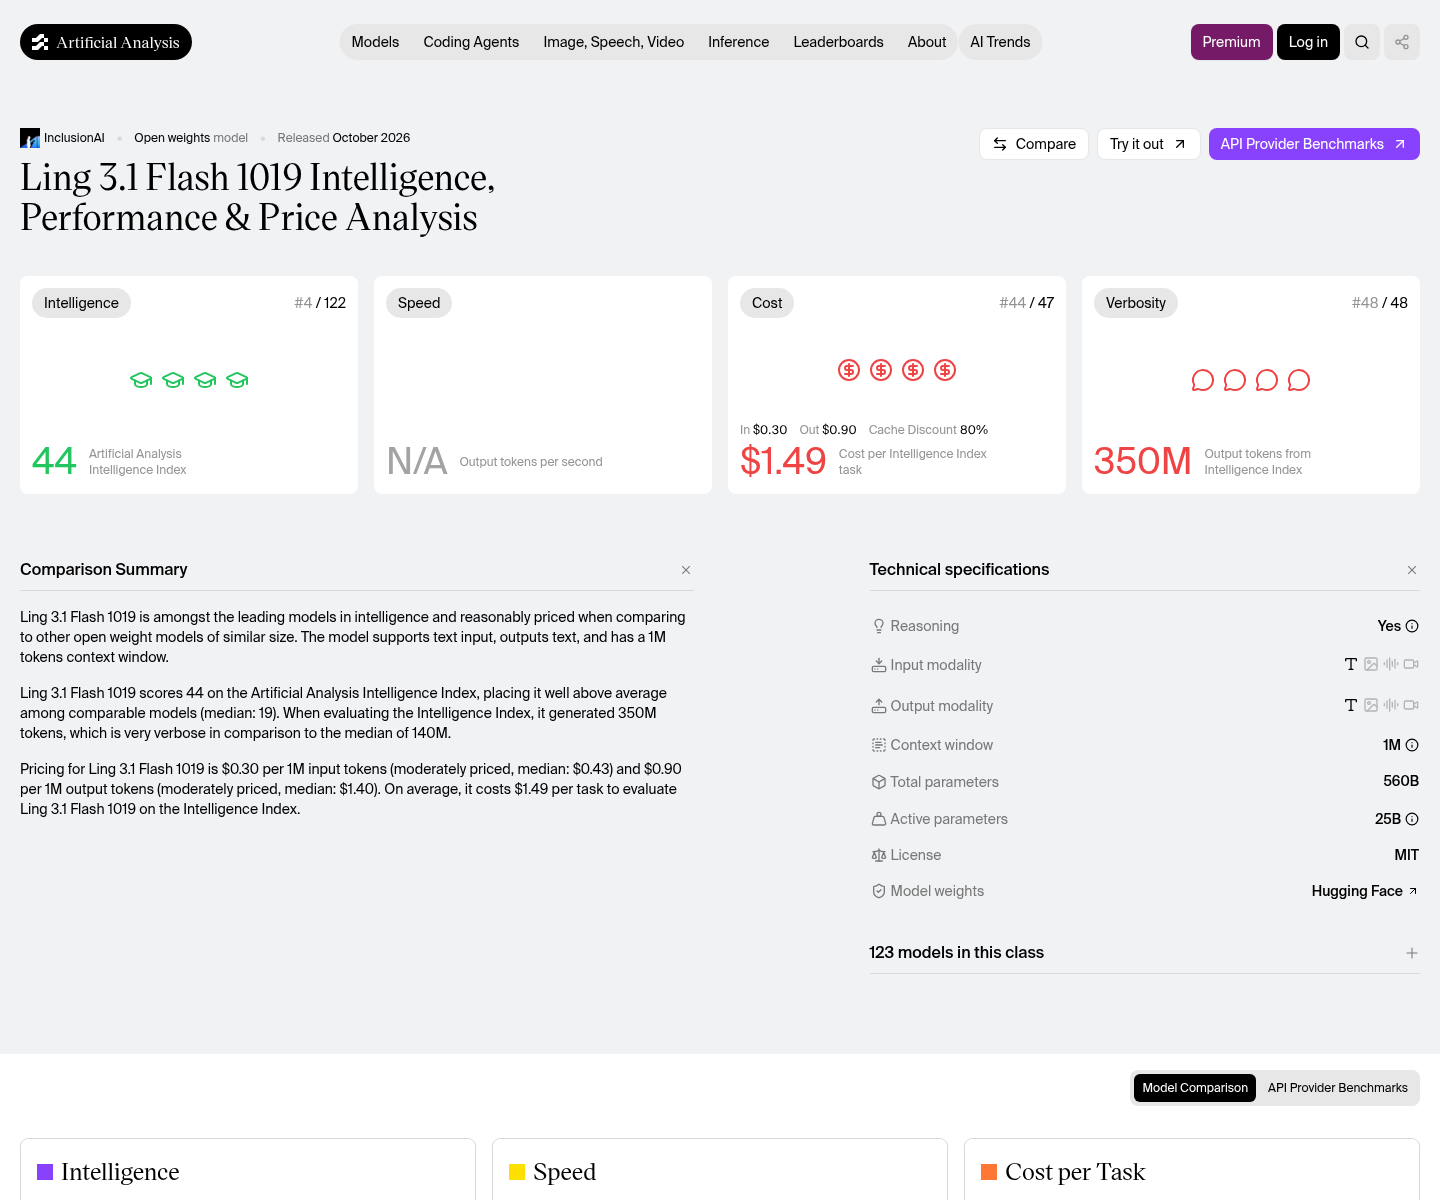
Mô hình trọng số mở là mô hình cho phép người dùng tiếp cận các tệp trọng số để tự kiểm tra, triển khai hoặc điều chỉnh, nhưng mức độ mở không tự động làm giảm yêu cầu phần cứng hay xác nhận mọi tuyên bố hiệu năng. Ngày 27 tháng 10, nhóm Ling của Ant Group đưa Ling-3.1-flash-1019 lên kho lưu trữ Hugging Face với 54 phân mảnh safetensors, tổng dung lượng 573,8 GB, theo giấy phép MIT. Đây là checkpoint đầy đủ, lượng tử hóa FP8, chứ không phải bộ điều hợp nhỏ gọn; cấu hình phát hành đặt giới hạn vị trí ở 262.144 token, tức 256K. Việc phát hành trọng số khiến tuyên bố có thể được cộng đồng kiểm tra, nhưng tải xuống, phục vụ và đo tốc độ vẫn là những việc riêng biệt. Với một mô hình lớn như vậy, “mở” là lời mời kiểm chứng, không phải lời hứa về khả năng tiếp cận phổ thông.
Cần tách cấu hình thực tế khỏi con số hấp dẫn trên thẻ mô hình. Ling-3.1 được mô tả có 560 tỷ tham số tổng cộng và 25 tỷ tham số hoạt động mỗi token; trong khi đó, tuyên bố ngữ cảnh một triệu token không khớp cấu hình phát hành 256K. Theo cấu hình có trong kho, tải nguyên trạng bằng các công cụ phục vụ được nêu trong tài liệu sẽ hỗ trợ 256K vị trí, trừ khi người vận hành bổ sung cấu hình mở rộng không có sẵn ở đó. Bản Ling-3.1-flash-base cũng là một tạo tác khác: checkpoint BF16 1,14 TB, dành cho tiếp tục huấn luyện và thích ứng, không phải lựa chọn trò chuyện trực tiếp chưa căn chỉnh. Hai kho đều mang giấy phép MIT, một điểm đáng kể cho nghiên cứu và tùy biến, nhưng giấy phép MIT AI không thu nhỏ chi phí vận hành hay xóa bỏ khác biệt giữa các biến thể.
Con số 23–4 là tín hiệu, chưa phải phán quyết
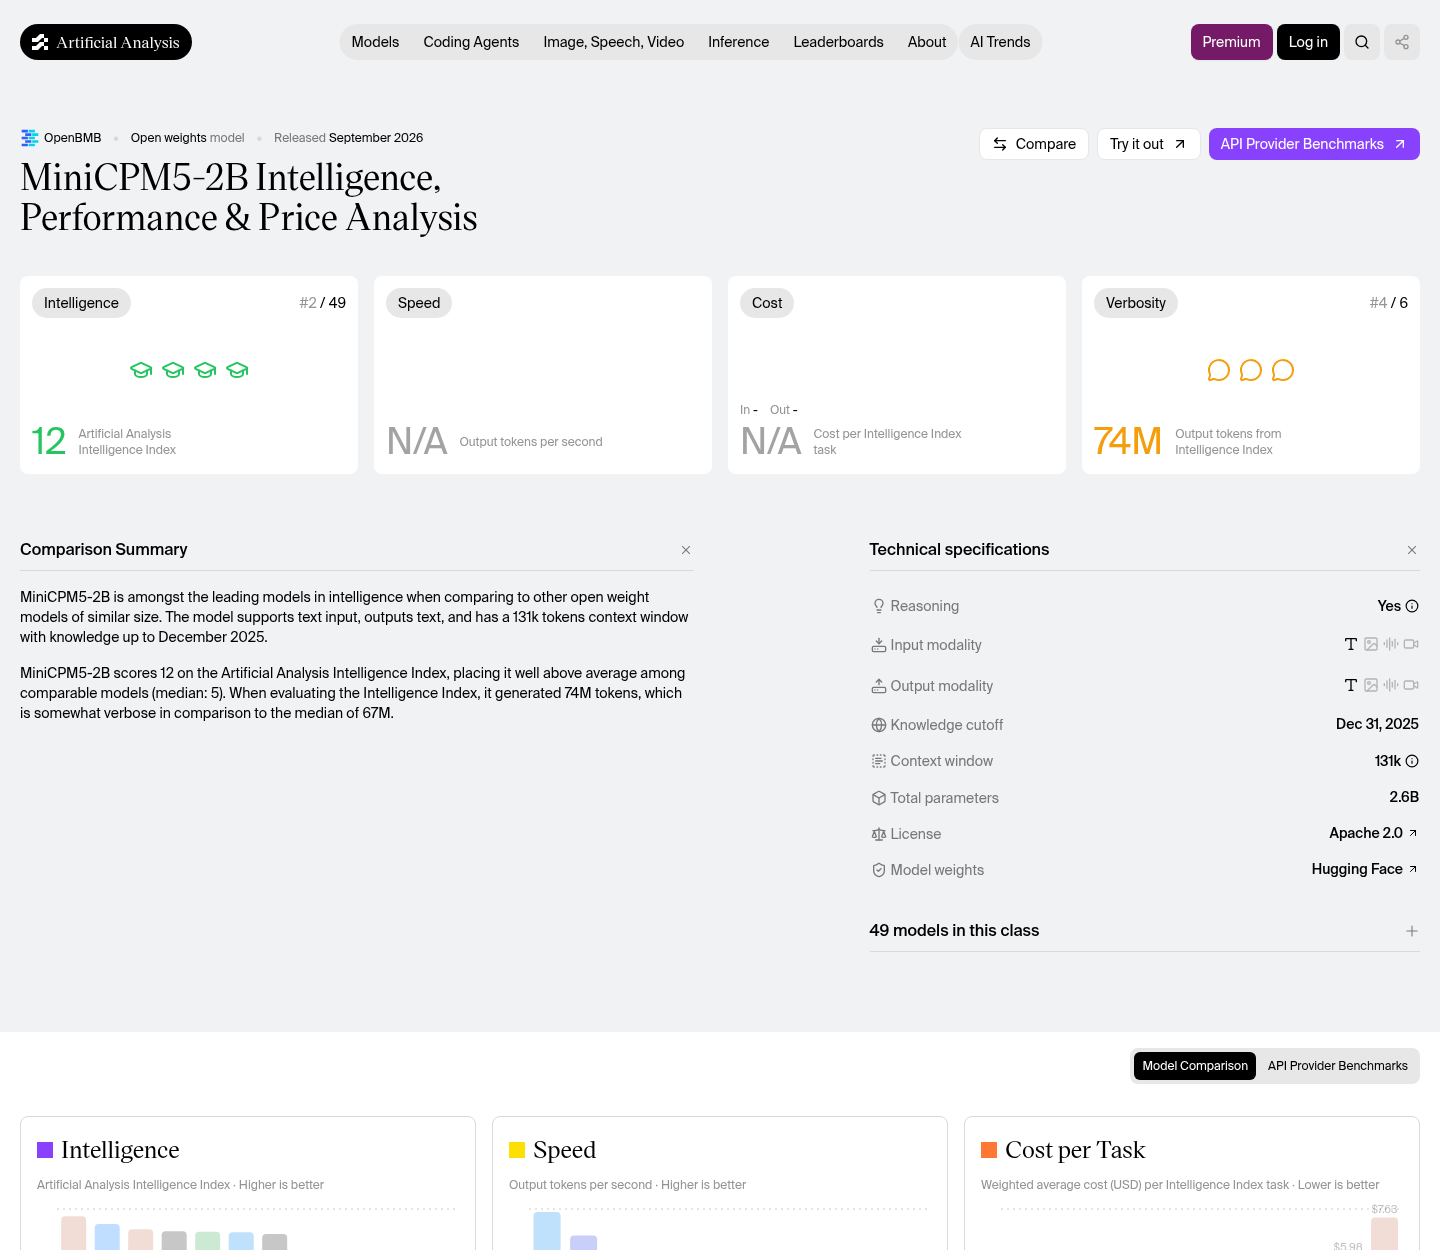
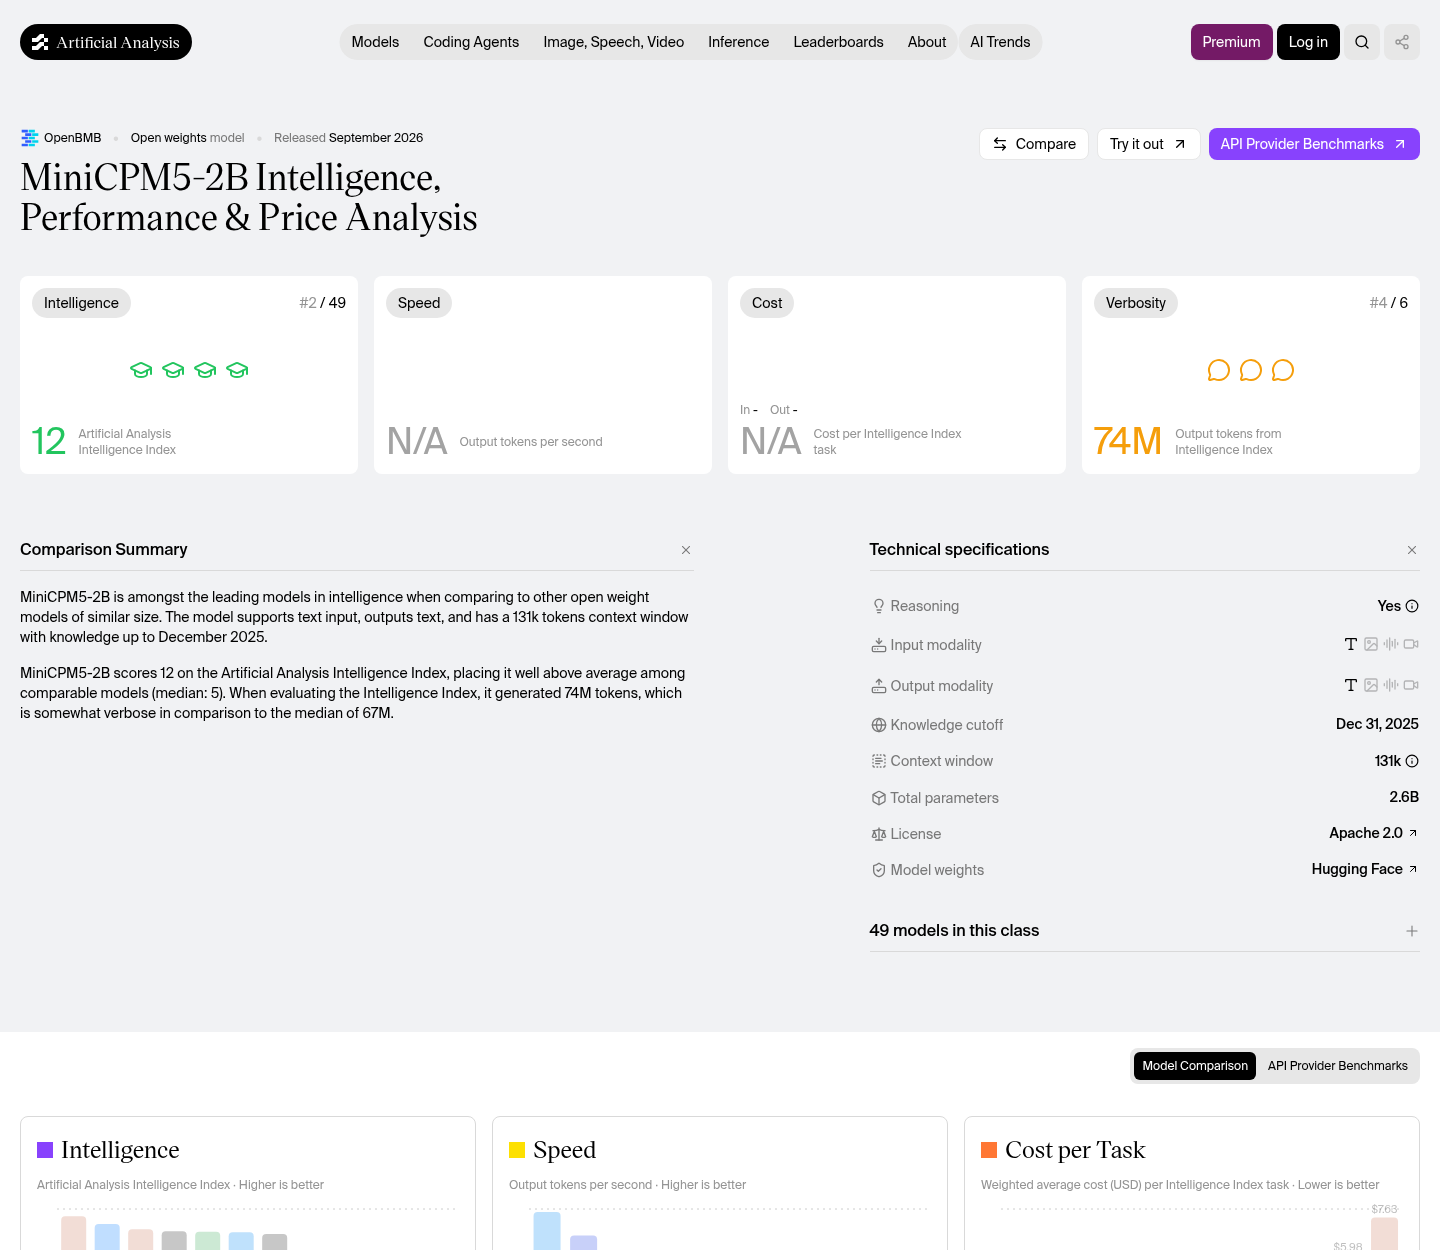
Cùng ngày 27 tháng 10 năm 2026, Liquid AI công bố bảng benchmark 27 dòng so sánh LFM3-1.7B với MiniCPM5-2B và cho biết LFM3 thắng 23 bài, MiniCPM5 thắng bốn. Hai mô hình nhắm đến phân khúc triển khai nhỏ hơn nhiều: LFM3-1.7B có 1,73 tỷ tham số, còn MiniCPM5-2B được mô tả là mô hình dense 2,52 tỷ tham số. Bảng điểm có giá trị vì Liquid chạy cả hai đối thủ trong cùng một bộ đánh giá của mình; nhưng đó vẫn là bộ khung do một bên lựa chọn và vận hành. Vì thế, tỷ số 23–4 là khởi điểm cho việc xem xét từng tác vụ, không phải bằng chứng rằng LFM3 luôn tốt hơn trong mọi môi trường. Đây là điểm mà cách đọc benchmark mô hình AI cần tỉnh táo hơn cách đọc bảng xếp hạng.
Những hàng trùng benchmark cho thấy vì sao. Với SWE-bench Verified, OpenBMB báo cáo MiniCPM5 đạt 46,4, trong khi phép đo của Liquid cho MiniCPM5 là 43,40 và LFM3 là 43,40; đặt số liệu của hai nhà cung cấp cạnh nhau có thể dẫn đến kết luận khác với phép so sánh nội bộ của Liquid. Ở BFCL V4 và Humanity’s Last Exam, điểm MiniCPM5 do Liquid đo cũng thấp hơn con số trên thẻ của OpenBMB. Sai khác không tự chứng minh bên nào gian lận; nó cho thấy harness, cách dựng prompt và chính sách thử lại có thể đổi kết quả. Đáng chú ý, tài liệu nguồn nói không nhà cung cấp nào công bố đầy đủ cấu hình harness, chính sách thử lại hay khung dựng prompt. Khi điều kiện chưa đồng nhất, độ chính xác của con số không thể thay thế khả năng so sánh.
Đọc theo tác vụ, giấy phép và phần cứng
Không nên vì nghi ngờ bảng điểm mà gạt bỏ mọi tín hiệu. Trong bộ đo của Liquid, LFM3 tạo khoảng cách lớn ở WebArena-Verified, 38,42 so với 9,11, và AutomationBench, 41,29 so với 4,71; RULER 128K cũng nghiêng về LFM3. Các chênh lệch đáng chú ý hơn vài điểm ở bài kiểm chuẩn khác, nhất là khi chúng phù hợp với mô tả LFM3 thiên về tác tử và nhận xét của OpenBMB rằng MiniCPM5 yếu hơn ở tác vụ nhiều bước dài. Nhưng RULER 128K là bài đo truy xuất ở độ dài đó, không phải bằng chứng MiniCPM5 bị giới hạn đúng 128K; mô hình này được nêu là hỗ trợ 131.072 token. Người dùng nên ưu tiên bài thử sát công việc của mình, thay vì gom mọi kết quả thành một thứ hạng duy nhất.
Khác biệt quy mô làm cho câu hỏi triển khai càng quan trọng. Ling-3.1-flash-1019 phù hợp hơn với tổ chức có năng lực phần cứng và nhu cầu tác tử hoặc nhiều bước; dung lượng 574 GB khiến đây không phải lựa chọn nhẹ nhàng cho máy cá nhân. Ngược lại, LFM3 và MiniCPM5 cạnh tranh ở nhóm nhỏ hơn, nơi bộ nhớ và khả năng chạy trên thiết bị có ý nghĩa trực tiếp. MIT cho Ling quyền sử dụng rộng rãi hơn về mặt giấy phép so với nhiều lựa chọn hạn chế, nhưng không thể lấy giấy phép để suy ra tốc độ, chất lượng hay chi phí phục vụ. Cũng vậy, lợi thế trên benchmark của Liquid không tự động chuyển thành lợi thế trong mọi triển khai. Quyết định đúng phải nối ba câu hỏi: giấy phép cho phép gì, phần cứng đáp ứng được gì, và tác vụ thực tế cần mô hình làm gì.
Bước tiếp theo phải là phép đo có thể lặp lại
Với Ling, khoảng trống lớn tiếp theo là thông lượng độc lập: tại thời điểm được mô tả, chưa có số liệu tốc độ đầu ra cho bản 1019, nên điểm benchmark không trả lời được mô hình vận hành nhanh đến đâu. Với cặp LFM3–MiniCPM, phép thử có sức thuyết phục hơn sẽ đưa cả hai qua cùng một harness, công bố cấu hình cùng kết quả và áp dụng quy tắc thử lại nhất quán. Một bài đánh giá như vậy cần phân biệt điểm truy xuất, năng lực tác tử và giới hạn ngữ cảnh, thay vì gộp chúng thành một con số thắng-thua. Người đọc cũng nên đòi hỏi kết quả tái lập từ bên không kiểm soát mô hình hoặc bộ đánh giá. Đó không phải thủ tục hình thức: khi chính cùng một benchmark cho ra thứ hạng khác nhau giữa các nguồn, phương pháp đo là một phần của kết quả.
Kết luận: Ling-3.1-flash-1019 đáng chú ý vì trọng số FP8 dung lượng lớn, giấy phép MIT và khả năng để bên ngoài kiểm tra; nhưng tuyên bố 1M token không nên được đánh đồng với cấu hình 256K đang phát hành. Bảng 23–4 của Liquid cung cấp dấu hiệu hữu ích về LFM3, đặc biệt ở một số tác vụ nhiều bước, song chưa thể thay thế phép so sánh độc lập và đồng nhất. Hãy xem benchmark là bằng chứng có điều kiện, không phải phán quyết cuối cùng. Chỉ khi thông số triển khai rõ ràng và hai mô hình được thử trong cùng điều kiện, người dùng mới có cơ sở vững hơn để chọn giữa độ mở, quy mô và năng lực theo tác vụ.